こんにちは、フリーランスエンジニアのmohです。この記事はほとんどAIが書いたものを、私が加筆修正しています。検証不十分な部分もあるかと思いますが、ご容赦ください。ご指摘等ございましたら、Github issueか、Xでお願いいたします。
前回の記事で、全文かな化の韻律劣化から phoneme 指定を持つ TTS への乗り換えを検討し、Fish Audio を候補に挙げました。Fish Audio の voice clone は、reference audio を API に渡すだけの zero-shot 方式です。事前に voice model を学習・登録しないということは、生成のたびに声がぶれる余地があるということでもあります。実運用に使うなら「毎回同じ声が出るのか」が気になります。同一 reference から、同一文の再試行・異なる文章・書き起こし省略・7 言語・voice model 登録との A/B の 6 実験で計 57 本を生成し、resemblyzer の話者 embedding のコサイン類似度で測りました。
結論
- 同一 reference・同一文 5 回の試行間類似度は 0.9449 ± 0.0156。文章を変えた 5 本の間でも 0.9525 で、文章を変えたことによる類似度の低下は観測されなかった
- reference の書き起こしを省略しても、同一文 5 回で試行間 0.9404 ± 0.0095、異文 5 本でも 0.9423 ± 0.0184 と同水準で、同じクローン声が出る (異文でも維持)。ただし尺と F0 のぶれは書き起こしなしの方が大きい (同一文で尺 std 0.76 秒、異文で 1.61 秒)
- 一方 reference と生成物の類似度は 0.92 前後 (実験1: 0.9163 ± 0.0103、実験2: 0.9275 ± 0.0063) で、生成物同士 (0.94〜0.95) より一貫して低い。ぶれの主成分は「試行間」でも「文章間」でもなく「reference からのずれ」
- つまり zero-shot clone は毎回「同じ、少し違う声」に安定して着地する。生成のたびに別人になる、という故障モードは観測されなかった
- voice model を登録して
reference_idで指定しても、発話間の一貫性は inline と実質同値だった (同一文×5 で 0.9599 vs 0.9623、permutation p=0.57。異文×10 ではむしろ登録側が悪化方向、p=0.16)。fast 登録は作成した瞬間にstate: "trained"が返り学習工程がなく、内部は同じ zero-shot とみられる。しかも登録側は reference への忠実度が系統的に低い (15 本中 13 本で inline を下回る) - 日本語 reference から 7 言語で生成すると、言語間の類似度は 0.8708 ± 0.0356、ref–言語も 0.8959 ± 0.0187 まで下がり、日本語内 (0.94〜0.95) では見えなかった低下が現れた。言語判定は 7/7 でターゲット言語どおり
- 同一文でも音声の尺は std 0.33 秒でぶれる。リップシンクなど尺が効く動画用途ではこの非決定性が効いてくる
- 測定は resemblyzer 単一指標で、異文ペアには音素内容差が混入する。聴感評価は別途必要
手法
- モデル:
s2.1-pro。inline zero-shot clone (referencesに reference wav バイナリ + 書き起こしテキストを渡す。事前 voice 登録なし) - reference: 自分の声 約 10 秒 (24kHz mono)
- 実験1: 日本語 3 文 (固有名詞なし) を 5 回とも完全に同一で生成
- 実験2: 互いに異なる日本語 5 種 (各 3 文・同程度の長さ・固有名詞なし) を各 1 回生成
- 5 回逐次実行 (リクエスト間 2 秒スリープ)、出力は
format="wav"そのまま。両実験とも 5/5 成功 - 話者類似度: resemblyzer
VoiceEncoderの 256 次元 utterance embedding 同士のコサイン類似度。F0 は librosapyin
測定コードは blog-examples に置いてあります。
実験1: 同一文を5回生成する
同じ reference・同じテキストで 5 回生成し、6x6 (ref + trial1..5) の類似度行列を取りました。
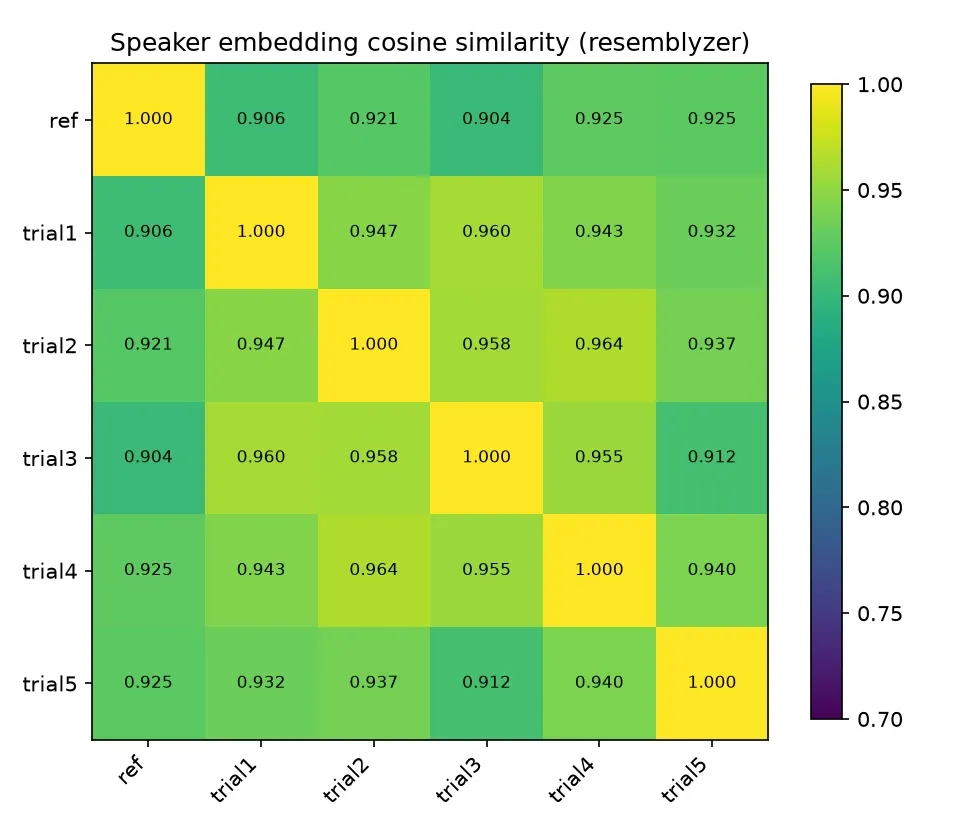
- 試行間 (10 ペア): mean 0.9449 / std 0.0156 / min 0.9120 / max 0.9641
- ref–trial (5 ペア): mean 0.9163 / std 0.0103 / min 0.9040 / max 0.9252
5 試行は互いに近い声にまとまっており、ref–trial の std も 0.0103 と小さいので、忠実度が試行によって大きく上下することもありません。実際に 2 本聴いてみてください。trial3 は試行間の最小ペア (trial3–trial5: 0.9120) 側の 1 本です。
trial1:
trial3:
もうひとつの観察は尺です。テキストが完全に同一でも、音声の長さは 12.585〜13.421 秒 (mean 12.9658s / std 0.3257s) と毎回変わります。サンプリング生成の非決定性がそのまま尺に出ています。
実験2: 文章を変えて5本生成する
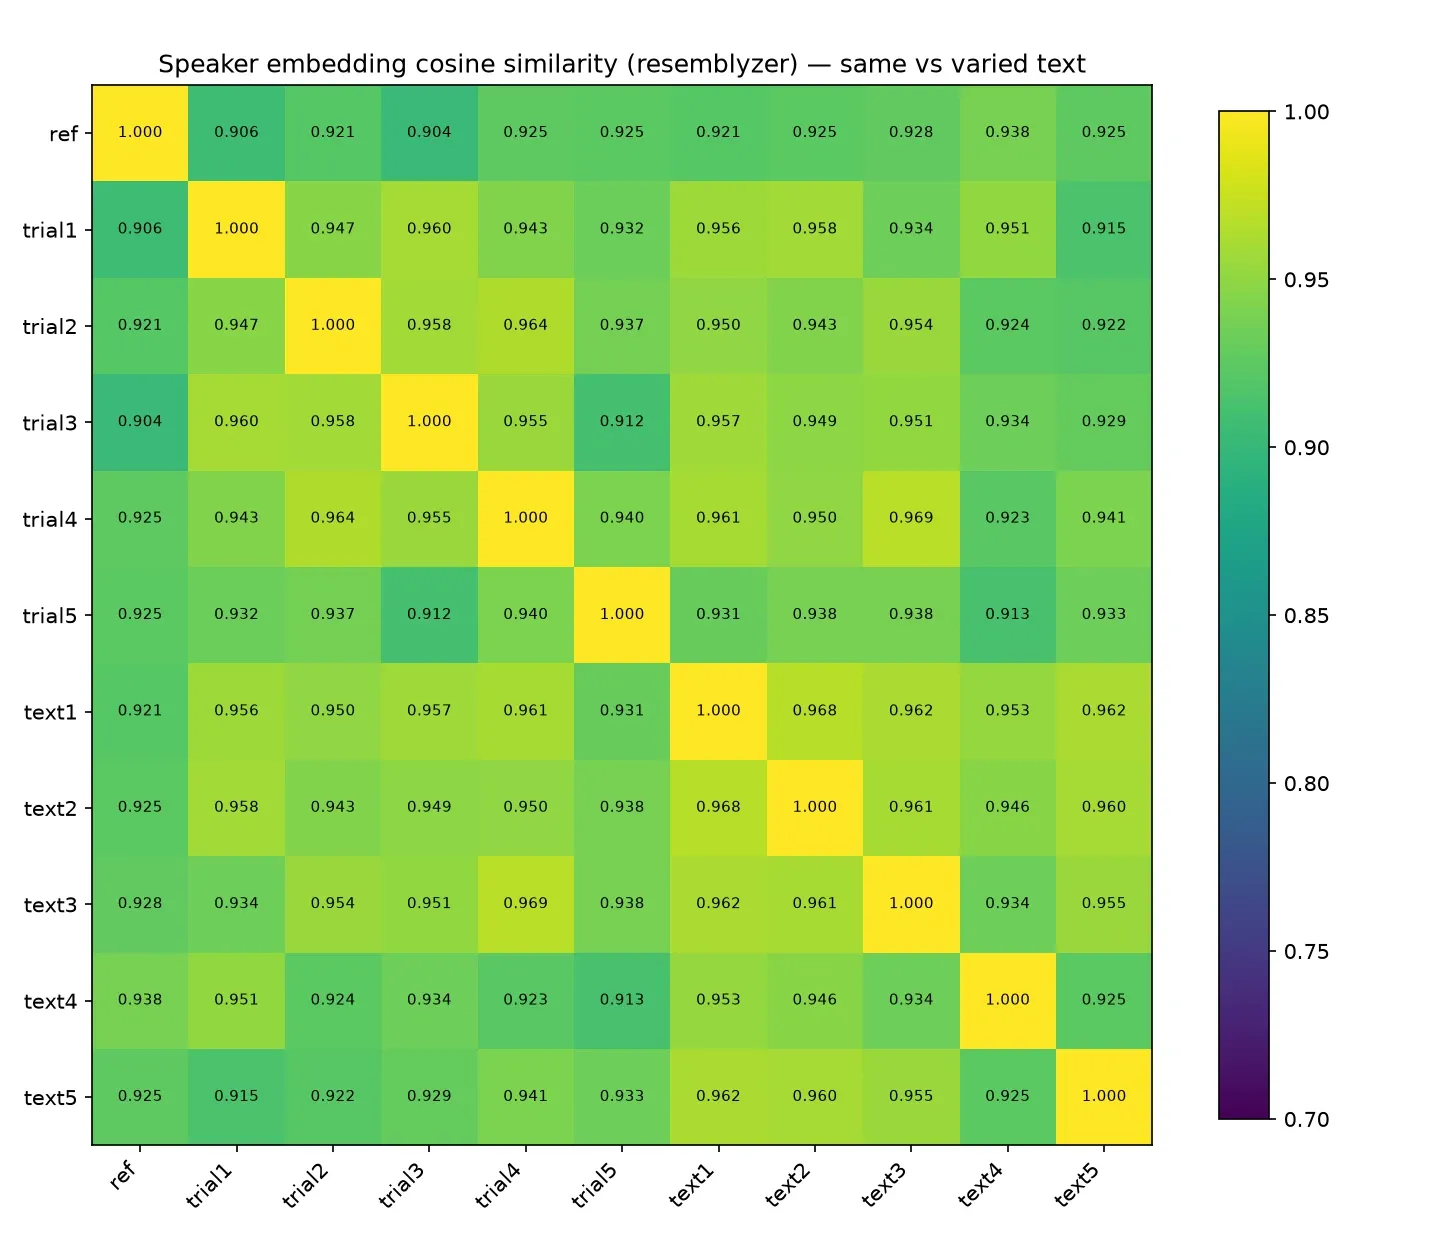
次に「文章が変わっても声が維持されるか」です。同一 reference で互いに異なるテキスト 5 種を各 1 回生成し、実験1 の 5 本と合わせて 11x11 の類似度行列を取りました。
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| 実験1 trial 間 | 同一テキスト同士 | 10 | 0.9449 | 0.0156 | 0.9120 | 0.9641 |
| 実験1 ref–trial | 異テキスト (ref は独自文章) | 5 | 0.9163 | 0.0103 | 0.9040 | 0.9252 |
| 実験2 ref–text | 異テキスト (ref は独自文章) | 5 | 0.9275 | 0.0063 | 0.9214 | 0.9380 |
| 実験2 text 間 | 異テキスト同士 | 10 | 0.9525 | 0.0138 | 0.9245 | 0.9676 |
| クロス text×trial | 異テキスト同士 | 25 | 0.9411 | 0.0150 | 0.9128 | 0.9692 |
text 間 (0.9525) は同一テキストの trial 間 (0.9449) を下回っておらず、実験1 と実験2 をまたぐクロスセット (0.9411) も同水準です。ref–text (0.9275) も実験1 の ref–trial (0.9163) と同水準で、reference への忠実度が文章に依存して劣化する様子はありません。実験2 の 40 ペア (text 間 10 + クロス 25 + ref–text 5) の最小値は 0.9128 で、別人化のような崩壊的な変化も観測されませんでした。
こちらも 2 本置いておきます。
text1:
text4:
実験3・4: reference の書き起こしを渡さない
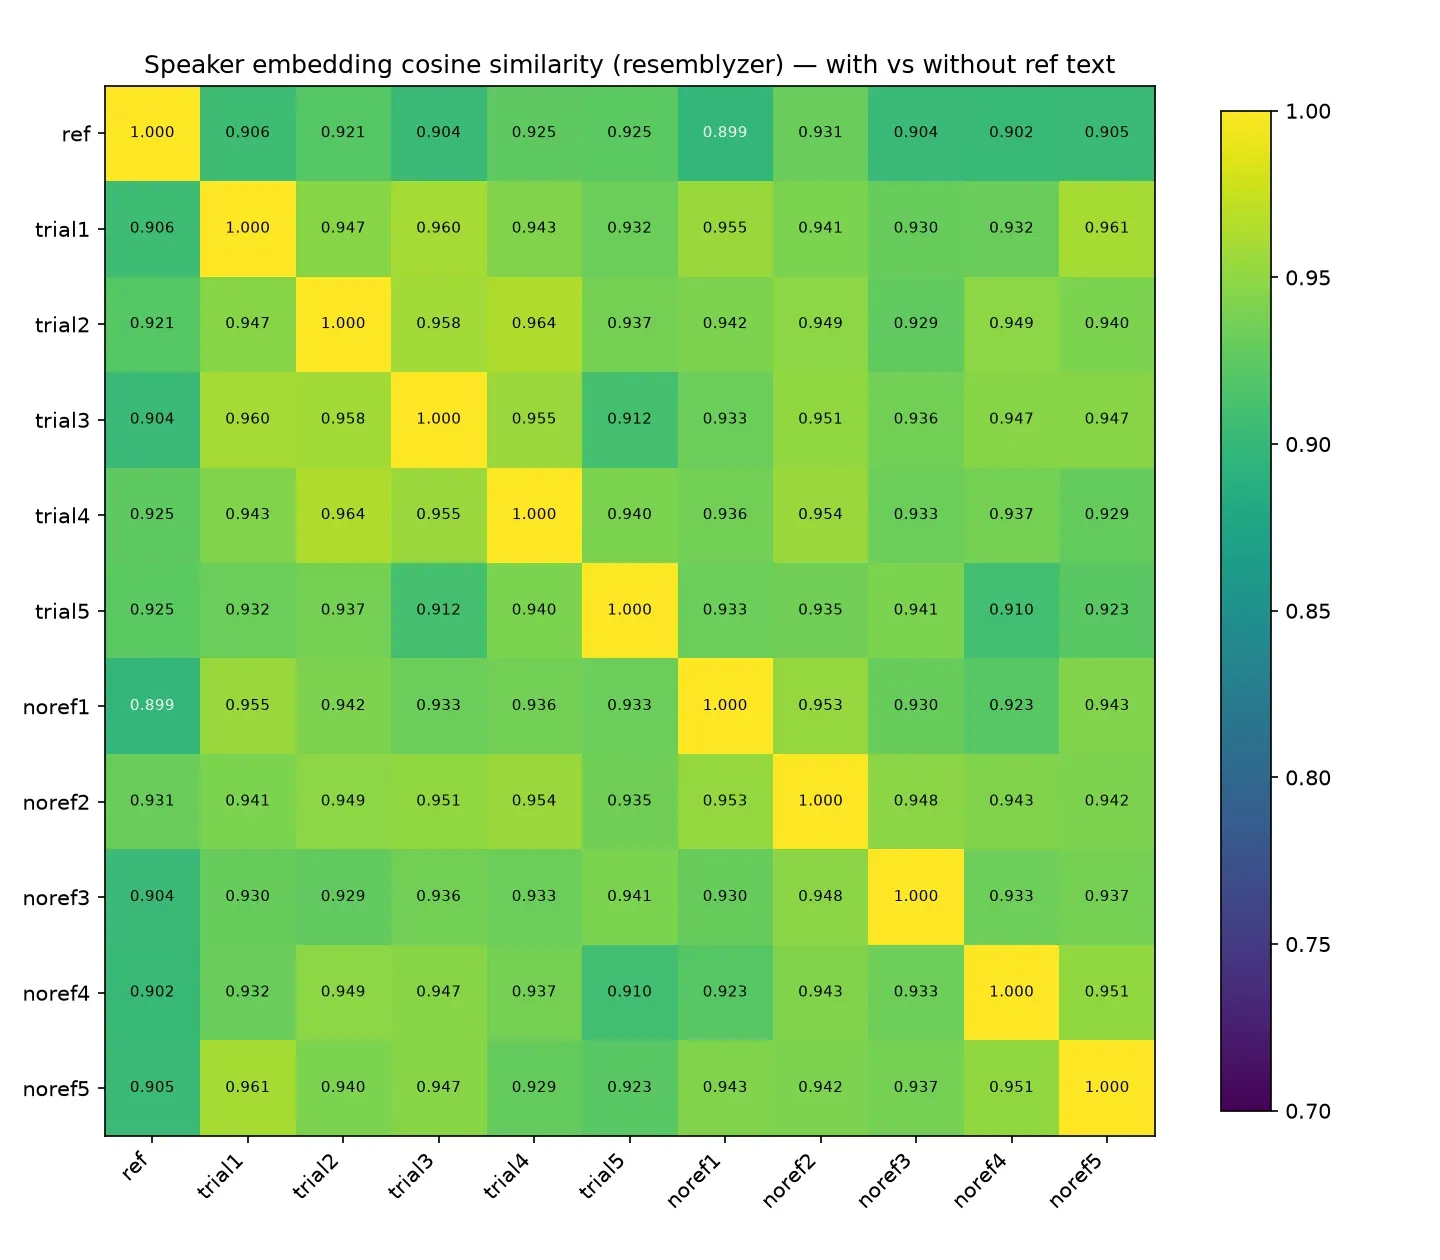
実験1 と実験2 は references に reference audio の書き起こしテキストを添えていました。この書き起こしを用意するのは地味に手間なので、渡さなかったら何が変わるのかを、実験1 と完全同一条件 (同一 reference・同一文・5 回) で測りました。SDK の ReferenceAudio.text は必須フィールドのため、省略ではなく空文字列を渡しています。
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| 実験1 trial 間 | 書き起こしあり同士 | 10 | 0.9449 | 0.0156 | 0.9120 | 0.9641 |
| 実験1 ref–trial | 書き起こしあり | 5 | 0.9163 | 0.0103 | 0.9040 | 0.9252 |
| 実験3 ref–noref | 書き起こしなし | 5 | 0.9081 | 0.0131 | 0.8988 | 0.9312 |
| 実験3 noref 間 | 書き起こしなし同士 | 10 | 0.9404 | 0.0095 | 0.9227 | 0.9525 |
| クロス noref×trial | なし × あり | 25 | 0.9389 | 0.0113 | 0.9096 | 0.9608 |
noref 間 (0.9404) は実験1 の trial 間 (0.9449) と同水準で、書き起こしありの実験1 とまたぐクロスセット (0.9389) も同水準です。書き起こしの有無で別の声になるわけではありません。ref–noref (0.9081) は実験1 の ref–trial (0.9163) よりわずかに低いですが、差は mean で 0.008 程度で、n=5 の std を考えると明確な劣化とまでは言えません。一方で尺は 11.146〜13.003 秒 (std 0.7597s) と実験1 (12.585〜13.421 秒、std 0.3257s) より短め・ばらつき大きめで、F0 mean の試行間幅も 9.24 Hz と実験1 の 2.35 Hz より広く、韻律まわりのぶれは書き起こしなしの方が大きく出ました。
noref1:
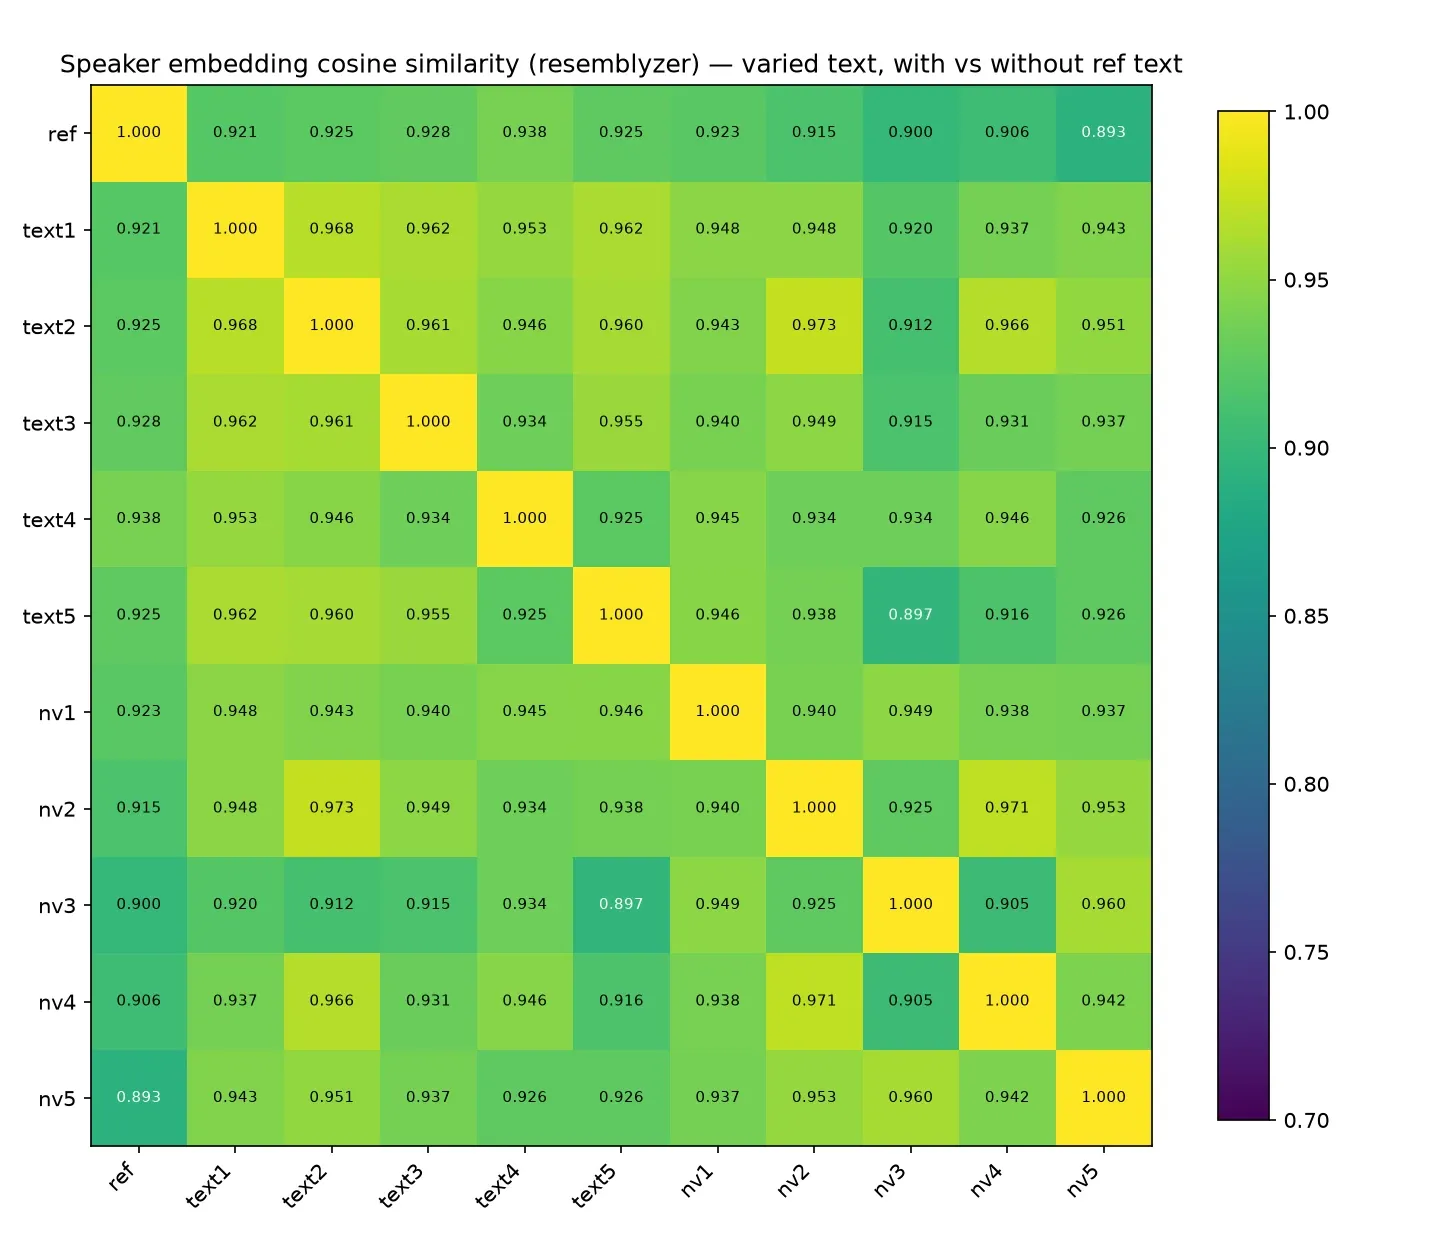
最後に実験4 として、書き起こしなしのまま文章も変えるとどうなるかを測りました。生成テキストは実験2 と完全同一の 5 種、reference の扱いは実験3 と同一 (空文字列) で、これで書き起こし有無 × 同一文/異文の 2x2 マトリクスが埋まります。
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| 実験2 text 間 | あり × 異文同士 | 10 | 0.9525 | 0.0138 | 0.9245 | 0.9676 |
| 実験2 ref–text | あり × 異文 | 5 | 0.9275 | 0.0063 | 0.9214 | 0.9380 |
| 実験3 noref 間 | なし × 同一文同士 | 10 | 0.9404 | 0.0095 | 0.9227 | 0.9525 |
| 実験3 ref–noref | なし × 同一文 | 5 | 0.9081 | 0.0131 | 0.8988 | 0.9312 |
| 実験4 nv 間 | なし × 異文同士 | 10 | 0.9423 | 0.0184 | 0.9051 | 0.9715 |
| 実験4 ref–nv | なし × 異文 | 5 | 0.9076 | 0.0121 | 0.8926 | 0.9234 |
| クロス nv×text | なし × あり (異文) | 25 | 0.9369 | 0.0169 | 0.8972 | 0.9735 |
| クロス nv×noref | なし同士 (文章またぎ) | 25 | 0.9420 | 0.0163 | 0.9096 | 0.9657 |
nv 間 (0.9423) は実験2 の text 間 (0.9525)・実験3 の noref 間 (0.9404) と同水準で、書き起こしありの実験2 とまたぐクロス (0.9369)、実験3 とまたぐクロス (0.9420) も同水準。書き起こしなし × 異文でも声は維持されています。ref–nv (0.9076) は実験3 の ref–noref (0.9081) とほぼ同じで、書き起こしなし条件の 2 実験がそろって書き起こしあり (0.9163 / 0.9275) を下回る並びになりました。一方で尺は 12.260〜16.312 秒 (std 1.6117s) と実験2 (14.814〜16.735 秒、std 0.7044s) よりぶれが大きく、F0 mean の幅も 11.22 Hz と実験2 の 2.92 Hz より広く、韻律のぶれが書き起こしなしで大きくなる傾向は異文でも再現しました。
実験4 の 1 本目です (文章は実験2 の text1 と同一)。
実験5: 言語を変える
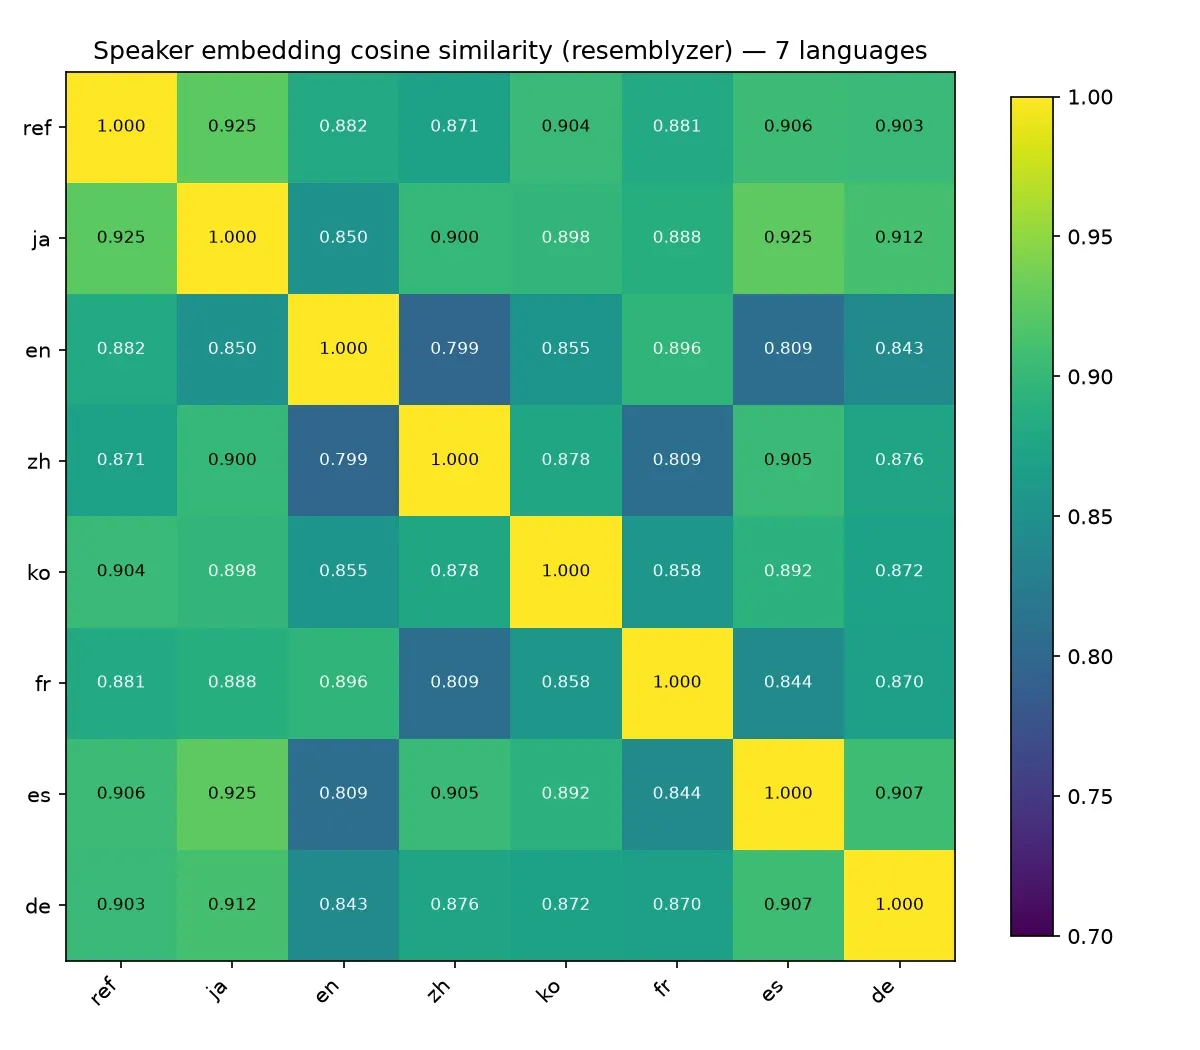
最後に、言語をまたいでも同じクローン声が出るかです。以前の記事で多言語 zero-shot 生成を比較したときと同じ 7 言語のテキスト (ja / en / zh / ko / fr / es / de) を、同一の日本語 reference から各 1 回生成しました。条件は実験1・2 と同じ標準形 (書き起こしあり) です。
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| 実験2 text 間 | 日本語異文同士 | 10 | 0.9525 | 0.0138 | 0.9245 | 0.9676 |
| 実験2 ref–text | 日本語異文 | 5 | 0.9275 | 0.0063 | 0.9214 | 0.9380 |
| 実験5 ref–言語 | 7 言語 | 7 | 0.8959 | 0.0187 | 0.8705 | 0.9245 |
| 実験5 言語間 | 異言語同士 | 21 | 0.8708 | 0.0356 | 0.7991 | 0.9253 |
| 実験5 ja–他言語 | 異言語同士 (ja 起点) | 6 | 0.8955 | 0.0257 | 0.8501 | 0.9253 |
| クロス 言語×text | 異言語 × 日本語異文 | 35 | 0.8943 | 0.0261 | 0.8453 | 0.9376 |
前提として、そもそも指定言語で喋れているかを faster-whisper (small) で確認したところ、言語判定は 7/7 でターゲット言語と一致し、書き起こしも生成テキストと一致していました。指定言語で喋らない・内容が破綻するといった故障はありません。
数値は、ここまでの実験と初めて違う動きをしました。言語間 (0.8708) は日本語異文間 (0.9525) を明確に下回り、ref–言語 (0.8959) も日本語の ref–text (0.9275) より低い。最小は en–zh の 0.7991 で、ja–他言語でも ja–en (0.8501) が突出して低い一方、ja–es (0.9253)・ja–de (0.9120) は日本語内ベースラインに近い水準です。ただしこの低下には、声質変化のほかに音素体系の差と resemblyzer の言語バイアス (後述) が混ざっており、しかも各言語 5〜6.5 秒の短い発話 1 本ずつなので、声質変化の量としては読めません。崩壊的な別人化 (全 63 ペア最小 0.7991) は観測されていません。
en と zh を置いておきます。
en:
zh:
実験6: voice model を登録すると声は安定するのか
ここまでの実験はすべて inline zero-shot (リクエストごとに references で reference audio を渡す) でした。Fish Audio にはもうひとつ、reference audio を voice model として事前に登録し、生成時は reference_id で指定する方式があります。「登録」という語感からは、声が固定されて生成ごとの揺らぎが減ることを期待したくなります。本当にそうなのかを A/B で確かめました。
- voice model は SDK の
create_modelでtrain_mode: "fast"・visibility: "private"を指定して作成 (reference は実験1〜5 と同一)。実験後に削除しています - 同一文×5 回 (実験1 と同一文) + 異文×10 本 (実験2 の 5 種 + セリフ調の短文 5 本) を、テキストごとに inline (A) → 登録 (B) の対で生成し、時間帯によるドリフトを条件間で均しました
- temperature / top_p は SDK 既定値 0.7 / 0.7 で両条件共通です
発話間のペア類似度は次のとおりです。
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| inline | 同一文×5 | 10 | 0.9599 | 0.0088 | 0.9427 | 0.9716 |
| 登録 (reference_id) | 同一文×5 | 10 | 0.9623 | 0.0101 | 0.9464 | 0.9751 |
| inline | 異文×10 | 45 | 0.9231 | 0.0248 | 0.8806 | 0.9667 |
| 登録 (reference_id) | 異文×10 | 45 | 0.9142 | 0.0337 | 0.8170 | 0.9625 |
同一文は 0.9599 vs 0.9623 で実質同値 (permutation test p=0.57)、異文はむしろ登録側の方が分散が大きく最小値も低い (p=0.16 で有意差なし) という結果で、「登録すれば声が一貫する」は成立しませんでした。傍証もあります。fast モードの voice model は作成した瞬間に state: "trained" が返ってきて、学習工程が存在しません。揺らぎ幅も inline と同一水準なので、内部は inline と同じ zero-shot と考えるのが自然です。尺の std も同一文×5 で inline 0.237 秒 vs 登録 0.330 秒と同水準で、尺の非決定性も登録では安定化しませんでした (なお inline 同一文×5 の 0.9599 は別日の実験1 の 0.9449 より高めで、日をまたぐとこの程度の変動はあるようです。だからこそ A/B は同日に対で生成しています)。
予想外だったのは忠実度の方です。ref–生成物の類似度は、同一文×5 で inline 0.9291 vs 登録 0.9100、異文×10 で 0.9191 vs 0.8858 と、登録側が 15 本中 13 本で対応する inline を下回りました。登録経路はデフォルトで reference audio にエンハンス処理をかける (create_model の enhance_audio_quality、SDK default True) ので、この前処理が声を ref から系統的に動かしている可能性があります。同一テキスト対の inline–登録間類似度は mean 0.9240 で条件内ペアと同水準なので、登録側が「別の固定された声」になっているわけではなく、同じクローンの揺らぎの範囲で ref から少し遠くなっている、という格好です。
同一文の 1 本ずつを置いておきます。
inline:
登録 (reference_id):
ぶれの主成分は reference からのずれ
上の表を縦に読むと、構図がはっきりします。生成物同士の類似度 (0.94〜0.95) は、条件を問わず ref–生成物 (0.92 前後) より高い。ヒートマップでも ref の行だけが一段低く見えます。
つまり zero-shot clone の出力は、試行や文章でランダムにばらつくのではなく、「reference から一定距離ずれた声」に毎回安定して着地しています。ずれの向きが毎回同じかまでは embedding の距離だけでは言えませんが、少なくとも「clone した声が生成のたびに別の声になる」ことを心配する必要は、この条件では無さそうです。心配すべきはむしろ「reference 本人と clone は最初から少し違う」という定常的なずれの方で、これは試行を重ねても縮みません。
F0: ピッチ帯は文章に引っ張られるかもしれない
F0 mean は実験1 が 100.27〜102.62 Hz (幅 2.35 Hz)、実験2 が 104.26〜107.18 Hz (幅 2.92 Hz) でした。各実験の中では安定していますが、実験2 の方が全体にやや高い側に寄っています。embedding では両実験に差が出ていないので話者性としては同じ声ですが、ピッチ帯は文章の内容に引っ張られる可能性があります。n が小さいので、傾向の指摘に留めます。
指標の限界
- resemblyzer の utterance embedding は話者性を主に捉えますが、音素内容 (何を喋っているか) の影響を完全には除去できません。異テキスト間の類似度には声質差と音素内容差の両方が混ざっており、本測定だけでは分離できません
- ref はどの生成物とも文章が異なるため、ref–生成物の類似度は常に音素内容差込みの値です。この値が実験1 と実験2 で同水準だったことが「忠実度は文章に依存しない」の根拠です
- resemblyzer の VoiceEncoder は英語中心のデータセット (VoxCeleb 系) で学習されており、実験5 の言語間類似度には encoder の言語バイアスも混入します
- 実験6 の短文 (セリフ調 5 本、4〜5 秒) は embedding が不安定でペア類似度が低く出ます。ただし両条件で同一テキストセットを共有しているため、inline vs 登録の A/B 比較自体への影響は小さいはずです
- 単一指標の客観測定であり、聴感上の同一性・韻律の自然さは別途評価が必要です
まとめ
Fish Audio の inline zero-shot clone は、同一文の再試行でも、異文でも、reference の書き起こしを省略しても、話者 embedding 上は 0.94〜0.95 の水準で同じ声に着地しました。ぶれの主成分は reference からの定常的なずれ (0.92 前後) で、これは生成の度に変わるものではありません。「毎回同じ声が出るのか」への答えは「毎回、同じ少し違う声が出る」です。この揺らぎは voice model を登録して reference_id で指定しても変わらず (実験6)、むしろ登録側は reference への忠実度で損をしました。登録で声を固定することはできません。言語をまたぐと類似度は 0.87 前後まで下がり、日本語内では見えなかった低下が現れますが、これは指標の言語バイアス込みの数値です。
実務側の注意はひとつで、同一テキストでも尺が ±0.3 秒程度ぶれることです。声のためだけなら無視できますが、リップシンクや既存映像への差し替えなど尺に制約のある動画用途では、生成のたびに長さが変わる前提で設計する必要があります。