こんにちは、フリーランスエンジニアのmohです。この記事はほとんどAIが書いたものを、私が加筆修正しています。検証不十分な部分もあるかと思いますが、ご容赦ください。ご指摘等ございましたら、Github issueか、Xでお願いいたします。
Remotion でサーバー側のレンダーを回していると、「字幕の ON/OFF を変えただけなのに、動画を全部描き直している」という場面が出てきます。背景の動画に透過 webm の人物を重ねて、その上に字幕を載せる構成だと、字幕は最前面のレイヤーにすぎません。それなら、字幕なしで作った完成動画を取っておいて、字幕だけあとから足せば安く済むのではないか、と考えました。
足し方は 2 つ思いつきます。完成動画を Remotion に 1 本の動画として読ませて字幕を描き足す方法と、字幕だけを透過動画として Remotion に描かせて ffmpeg で重ねる方法です。どちらがどれだけ速いのかを、GCE の 4 vCPU の VM で測りました。
結論
- 全部を描き直す場合を 100% とすると、完成動画に字幕を描き足す方法は 79%、字幕だけ透過で描いて ffmpeg で重ねる方法は VP9 で 71%、ProRes 4444 で 84% でした。どの方法でも 2〜3 割しか下がりません
- 動画を 1 本も読まない「字幕だけ」のレンダーでも、動画 1 秒あたり 5.6〜6.5 秒かかりました。重いのは動画の読み込みではなく、全フレームを Chromium で描いてキャプチャし、透過つきでエンコードする部分です
- 透過 webm 1 本を重ねるコストは、動画 1 秒あたり約 1.9 秒で、全体の 2 割でした
- 字幕を描くこと自体のコストは、ほぼゼロでした
@remotion/mediaの<Video>で透過 webm を描くと、GPU のない Linux ではソフトウェア WebGL で動き、OffthreadVideoの 2.2 倍遅くなりました- ProRes と VP9 のどちらが速いかは、環境で入れ替わります。macOS では ProRes が VP9 の約 1/5 の時間でしたが、Linux の VM では ProRes のほうが遅くなりました
比べた方式
素材は全部 ffmpeg で作りました。背景はゆっくり動くグラデーションの h264、人物の代わりは縁をぼかした円が動く VP9 アルファつきの webm です。どちらも 1080x1920、30fps、60 秒です。字幕は自作のコンポーネントで、行ごとの表示、単語のハイライト、幅に合わせたフォントの縮小を入れています。全方式で同じコンポーネントを使います。
| 記号 | 内容 |
|---|---|
| X | 背景 + 透過 webm + 字幕を、Remotion で全部描く (h264) |
| P | X から字幕を抜いたもの。これが「字幕なしの完成動画」で、Y と Z の土台になる |
| Y | P を動画 1 本として Remotion に読ませ、字幕を描き足す (h264) |
| Z-vp9 | 字幕だけを透過の VP9 で描き、ffmpeg の overlay で P に重ねる |
| Z-prores | 同じことを ProRes 4444 でやる |
| W | 背景 + 字幕 (透過 webm なし)。X との差が、透過 webm のコストになる |
| X-video | X の透過 webm を、OffthreadVideo の代わりに @remotion/media の <Video> で描く |
X と P の透過 webm は、OffthreadVideo の transparent で描いています。Z の透過出力は、imageFormat: "png" に、VP9 なら pixelFormat: "yuva420p"、ProRes なら proResProfile: "4444" と pixelFormat: "yuva444p10le" を組み合わせます。
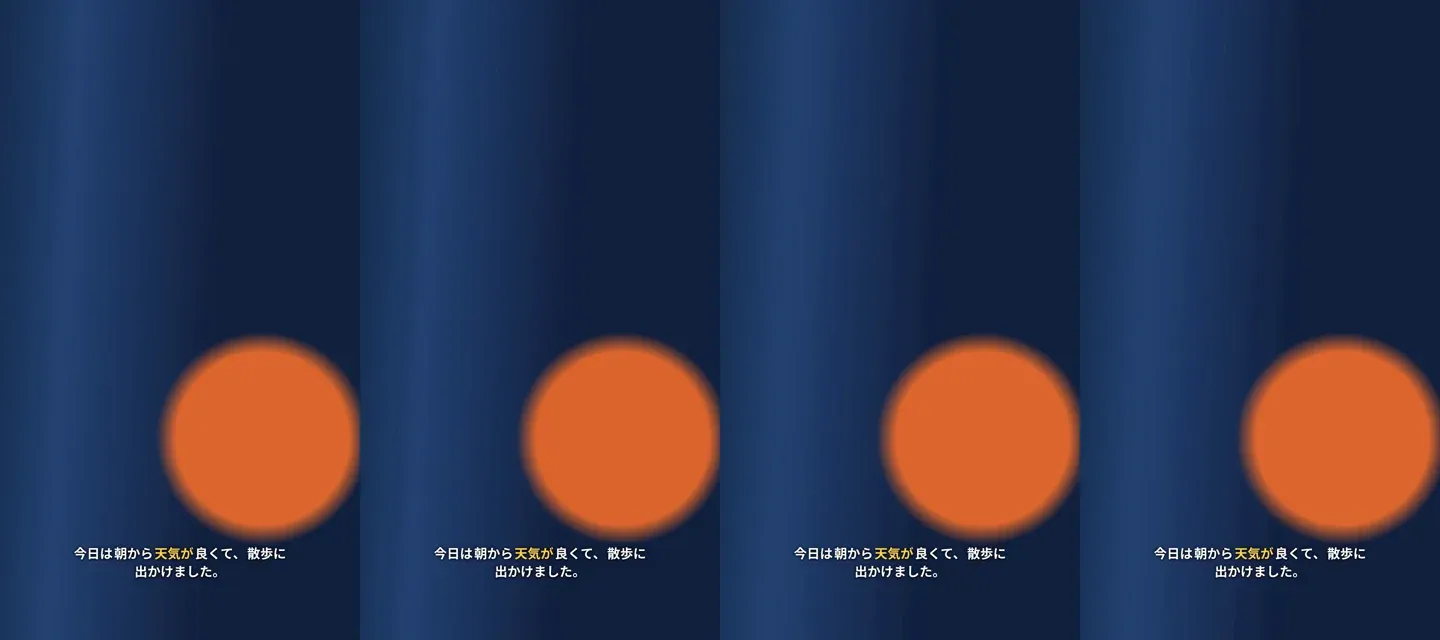
4 つの方式の出力から、同じ時刻のフレームを抜いて並べたものです。見た目は一致しています。
計測の環境
- GCE の
n2-standard-4(4 vCPU、16GB、Intel Xeon 2.80GHz)、Debian 12 - bun 1.4.2、Remotion 4.0.459、Chrome Headless Shell (Chromium 149)
- ffmpeg は、overlay に apt の 5.1.9 を使いました。Remotion の内部のエンコードは、同梱の ffmpeg です
- bundle は 1 回だけ作って、全条件で使い回しています。ブラウザも使い回しています。ただし、字幕のフォント (Noto Sans JP の 121 サブセット) の取得は、レンダーのたびに走っていて、計測値に含まれます。5 秒の尺でも 60 秒の尺でも X の秒/秒は同じ (9.13 と 9.14) だったので、この固定費は無視できる大きさだと判断しました
- 値は「動画 1 秒あたりの処理秒数」です。小さいほど速いです
concurrencyは、1 と Remotion の既定値の両方で測りました
同じ構成の VM を 3 台立てて、条件を分けて並列に回しています。台ごとの差を見るために、X (60 秒、concurrency 1) を 3 台で測りました。9.13〜9.20、9.03、8.94 で、差は 3% 以内でした。
最初は手元の Mac で測るつもりでした。ただ、計測中はほかの作業を止める必要があります。全条件で数時間かかる見積もりになったので、GCE に移しました。サーバーで回す想定の数字が取れたので、結果的にはこちらのほうがよかったと思います。
結果
60 秒の尺で、各条件を 3 回ずつ測った中央値です。括弧内は最小と最大です。
| 条件 | concurrency 1 | 既定値 |
|---|---|---|
| X | 9.14 (8.94〜9.20) | 6.70 (6.69〜6.71) |
| P | 9.25 (9.17〜9.28) | 6.73 (6.71〜6.77) |
| W | 7.26 (7.25〜7.26) | 5.27 (5.26〜5.28) |
| Y | 7.26 (7.23〜7.28) | 5.30 (5.28〜5.32) |
| Z-vp9 描く | 5.60 (5.59〜5.61) | 4.26 (4.23〜4.27) |
| Z-vp9 重ねる | 0.92 | 0.92 |
| Z-prores 描く | 6.54 (6.54〜6.57) | 5.12 (5.09〜5.14) |
| Z-prores 重ねる | 1.18 | 1.18 |
| X-video (n=1) | 20.40 | 17.83 |
回ごとのばらつきは 1% 前後で、ほとんどありませんでした。
字幕つきの完成動画を得るまでの合計を、concurrency 1 で並べるとこうなります。
| 作り方 | 秒/秒 | X との比 |
|---|---|---|
| X: 全部を描き直す | 9.14 | 100% |
| Y: 完成動画に字幕を描き足す | 7.26 | 79% |
| Z-vp9: 字幕だけ描く + 重ねる | 6.52 | 71% |
| Z-prores: 字幕だけ描く + 重ねる | 7.72 | 84% |
長い尺でも測りました。concurrency は既定値で、各 1 回です。
| 条件 | 尺 | 秒/秒 | 60 秒のときの値 |
|---|---|---|---|
| Y | 20 分 | 6.92 | 5.30 |
| Z-prores 描く | 5 分 | 5.07 | 5.12 |
| Z-prores 重ねる | 5 分 | 1.16 | 1.18 |
Z-prores は、尺にきれいに比例しました。Y は、20 分にすると 60 秒のときより約 3 割遅くなっています。原因は調べていません。
考察
重いのは「全フレームを描いてキャプチャする」部分
いちばん意外だったのは、字幕だけのレンダーが速くなかったことです。Z は動画を 1 本も読みません。描くのはテキストだけです。それでも動画 1 秒あたり 5.6〜6.5 秒かかります。X の 9.14 秒のうち、6 割以上が「Chromium で 1 フレームずつ描いて、キャプチャして、エンコードする」という土台の部分だったことになります。
内訳を引き算で出すと、こうなります。
- X − W = 約 1.9 秒。透過 webm 1 本を
OffthreadVideoのtransparentで読むコストです - X と P はほぼ同じです。字幕を描くコストは、計測の誤差に埋もれます
- W と Y は同じ 7.26 秒でした。背景の動画を読むのも、完成動画を読むのも、h264 を 1 本読むことに変わりはありません
Y で消えるのは、透過 webm 1 本ぶんだけです。重ねる透過 webm が 3 本、4 本と増える構成なら、Y の効果はそのぶん大きくなるはずです。今回は 1 本でしか測っていません。
透過出力は、キャプチャもエンコードも重い
Z が Y より大きく速くならないのは、透過で出すための条件が重いからだと見ています。透過出力では、フレームのキャプチャが JPEG ではなく PNG になります。コーデックも、アルファつきの VP9 か ProRes 4444 になります。
ProRes の 5 分の計測中に、VM の上でプロセスを観察しました。Remotion は、フレームのキャプチャを先に進めて、エンコードはあとから ffmpeg が追いかけます。全フレームのキャプチャが終わった時点で、出力ファイルは最終サイズの 3 割ほどでした。残りの時間は、ffmpeg が 4 コアを使い切ってエンコードを続けていました。この VM では、ProRes 4444 のエンコードが律速になっています。
ProRes の中間ファイルは、60 秒で 269MB、5 分で 1.35GB になりました。20 分なら 5GB を超えます。ディスクと転送のコストも、無視できません。
ProRes と VP9 の順位は、環境で入れ替わる
本番の計測の前に、手元の Mac (Apple Silicon) で 5 秒の動作確認をしていました。そのときは、ProRes の描画が 8.6 秒、VP9 が 41.1 秒で、ProRes が約 1/5 の時間でした。それを見て ProRes が本命だと考えていたのですが、Linux の VM では逆の結果になりました。
手元の結果でコーデックを決めて、本番に持っていくと外れます。透過出力のコーデックは、本番と同じ環境で測って決めるのがよさそうです。
<Video> は GPU のない環境では遅い
@remotion/media の <Video> は、アルファの合成に WebGL2 を使います。GPU のない Linux の VM では、ソフトウェア描画の WebGL で動いて、OffthreadVideo の 2.2 倍の時間がかかりました。Mac では、headless の Chromium で WebGL2 が取れず、OffthreadVideo に自動でフォールバックしました。どちらも、エラーにはなりません。黙って遅くなるか、黙って別の経路になります。
はまりどころ
計測の準備で、ドキュメントに見当たらない挙動に 3 つ当たりました。
OffthreadVideoや<Video>のsrcにfile://を渡しても、読めません。フレームの取得は、renderMediaが立てるローカルサーバーの/proxyを必ず通ります。その先は、http://かhttps://しか受け付けません。素材は bundle の出力ディレクトリにコピーして、相対パスで参照しました- libvpx-vp9 で
-b:v 0をつけて作った透過 webm は、OffthreadVideoのtransparentで読むと、アルファが全面 0 になります。図形が消えますが、エラーは出ません。ffmpeg のデコーダでは、正しく読めるファイルです。Remotion が VP9 アルファを書き出すときの内部のコマンドは、-b:vをつけずに-crfだけを使っています。それに合わせたら、読めるようになりました - ffmpeg の overlay に透過の VP9 を読ませるときは、入力側に
-c:v libvpx-vp9を明示しないと、アルファが無視されます。既定のvp9デコーダは、アルファのチャンネルを読みません。重ねる側の背景が、黒く塗りつぶされます。ProRes 4444 では、この指定は要りません
もう 1 つは、自分の実装のミスです。<AbsoluteFill> は、既定で display: flex; flex-direction: column を持っています。複数の OffthreadVideo を素の兄弟要素として並べると、重ならずに縦に並びます。2 枚目のレイヤーが画面の外に出て、見えなくなりました。レイヤーを 1 つずつ <AbsoluteFill> で包めば、重なります。
限界
- 素材は合成の図形で、人物の動画ではありません。デコードのコストは解像度とコーデックで決まると考えていますが、確かめてはいません
- 透過 webm は 1 本だけです。本数を増やしたときの伸び方は、測っていません
- 長い尺は、Y の 20 分と Z-prores の 5 分だけです。X と Z-vp9 の長い尺は、測っていません
- VM は
n2-standard-4の 1 種類です。コア数やメモリが違えば、concurrencyの既定値も、結果も変わります - 字幕にフェードなどの動きはありません
実務での扱い
「字幕だけ変えるなら安く済むはず」という見込みは、Remotion で字幕を描く限り、外れました。全フレームを描くコストが残るからです。処理時間を大きく減らしたいなら、全フレームを描かない作りにする必要があります。
字幕が変わるのは、行が切り替わる瞬間と、ハイライトが次の単語に移る瞬間だけです。その瞬間の静止画だけを Remotion で描いて、表示する時間をつけて ffmpeg で重ねれば、描く枚数は 30fps の全フレームから、単語の数の程度まで減ります。見た目は、同じコンポーネントのままにできます。これはまだ測っていないので、次に試すつもりです。
再現手順
コードと結果の JSON は、blog-examples に置いています。
bun install
bun run measure                 # 60 秒、3 回、全条件
LONG=1 bun run measure # 長い尺も測る尺、回数、条件、concurrency は、env か引数で上書きできます。素材は、初回に ffmpeg で生成します。全条件を回すと数時間かかるので、手元のマシンで回すときはご注意ください。