こんにちは、フリーランスエンジニアのmohです。この記事はほとんどAIが書いたものを、私が加筆修正しています。検証不十分な部分もあるかと思いますが、ご容赦ください。ご指摘等ございましたら、Github issueか、Xでお願いいたします。
前編で読みの良さを確かめた Irodori-TTS v4.1-Small に、「清水寺」のような単語だけを読ませたところ、声の前後に BGM のような音が鳴りました。原因を参照音声の条件に絞って切り分けた結果、参照音声にかけていた下処理 (無音を詰めて音量をそろえる) が主な原因と出ました。
結論
- 参照音声に下処理をかけると、短い入力 8 文 × seed 2 の 16 本すべてで、声の前に音が出ました。下処理後の長さを 12.87 秒にしても 15.54 秒にしても、2 回つないで 25.74 秒にしても同じです
- 同じ録音を切っただけの参照では、25.69 秒・15 秒の 32 本で音は出ませんでした。下処理後と同じ 12.87 秒に切った参照では、16 本中「こんにちは。」と「京都へようこそ。」の 4 本にだけ音が出ています
- 下処理は、無音を詰める (silenceremove) → 音量をそろえる (loudnorm) → 末尾に 0.5 秒の無音を足す、の 3 段で、途中でサンプルレートが 192kHz に上がります。どれが効いているかはまだ分けていません
- 下処理をかけていない別の 10 秒の参照でも、16 本すべてで音が出ました。理由は分かっていません
- 音が出た条件では、Irodori が予測する出力の長さも短くなりました。同じ単語で 0.8〜1.4 秒短く、声の前後の余白が詰まっています
- Irodori に渡す参照は、この下処理をかけず切るだけにするのが今のところ安全です。参照の下処理で結果が悪くなったのは、09-13 の Fish Audio の denoise に続いて 2 件目です
きっかけ
別の TTS が「しみずでら」「くえんじ」と読み違えていた清水寺と鹿苑寺を、Irodori に単語と文で読ませました (6 文 × seed 3 の 18 本)。前編と同じ方法でカタカナに書き起こすと、単語だけの 6 本のうち 4 本が「キミヨスデラ」「ロクオンシ。」のように崩れます。
ところが耳で聴くと、18 本すべて読みは正しく、崩れたのは書き起こしのほうでした。単語だけの音声には声の前後に BGM のような音が鳴っていて、書き起こしはそれに引きずられたように見えます。清水寺の 3 本は末尾 0.4 秒の音量が -12.4〜-15.5 dB で、声と変わらない大きさです。
このとき渡していた参照は、前編と同じ自分の声の 10 秒 (R10) です。前編の声の似方の比較で使った 26 秒の録音 (R26) に替えて短い入力を読ませると、音は消えました。ここから参照音声の条件を 1 つずつ変えて試しています。
試した条件
R26 から作った 6 通りの参照と、R10 を比べました。
| 条件 | 参照 | 長さ | 下処理 |
|---|---|---|---|
| R10 | 前編の 10 秒の参照 | 10.16 秒 | なし |
| A | R26 そのまま | 25.69 秒 | なし |
| B | R26 の先頭 15 秒 | 15.00 秒 | なし |
| C | R26 の先頭 15 秒に下処理 | 12.87 秒 | あり |
| D | C を 2 回つないだもの | 25.74 秒 | あり |
| E | R26 の先頭 12.87 秒 | 12.87 秒 | なし |
| F | R26 の先頭 18 秒に下処理 | 15.54 秒 | あり |
下処理は TTS の参照音声によくかけるもので、09-13 の記事でも全条件に共通でかけていました。
- 先頭 15 秒 (F は 18 秒) に切る
- -40 dB より静かな区間を、先頭は 0.2 秒、途中は 0.3 秒を超える分だけ詰める
- 音量を -18 LUFS にそろえる。サンプルレートを指定していないので、出力は 192kHz になる
- 末尾に 0.5 秒の無音を足す
条件は順に増やしました。C で音が出たとき、私は「15 秒に切ったあと無音を詰めて 12 秒台になったから、短すぎるのでは」と考えました。そこで同じ C を 2 回つないで倍の長さにしたのが D、中身のある長さで比べるために下処理なしで C と同じ 12.87 秒に切ったのが E、下処理後に 15 秒以上残るよう長めに切ったのが F です。
読ませた文は「はい」「ありがとう」「金閣寺」「嵐山」「伏見稲荷大社」の 5 語と、「こんにちは。」「京都へようこそ。」「次は嵐山です。」の 3 文で、それぞれ seed 1・2 の 2 本ずつ生成しました。条件ごとに 16 本です。
結果
声の前に音が鳴っているかを、出力の先頭 0.2 秒の音量で見ました。A と B は 32 本すべて -78 dB 台以下でほぼ無音なので、-60 dB より大きければ何か鳴っている目安にしています。
| 条件 | 下処理 | 先頭 0.2 秒が -60 dB より大きい本数 | 先頭 0.2 秒の範囲 (dB) |
|---|---|---|---|
| R10 | なし | 16 / 16 | -10.9〜-42.0 |
| A | なし | 0 / 16 | -78.7〜-81.3 |
| B | なし | 0 / 16 | -78.7〜-80.7 |
| C | あり | 16 / 16 | -7.2〜-35.6 |
| D | あり | 16 / 16 | -6.2〜-53.6 |
| E | なし | 4 / 16 | -16.0〜-80.8 |
| F | あり | 16 / 16 | -6.3〜-45.7 |
下処理ありの C・D・F は 48 本すべてで音が出ました。長さで説明できるかを見ると、15 秒以上の中身がある F でも音は出て、C と同じ 12.87 秒の E では単語 10 本と「次は嵐山です。」2 本の計 12 本が -78.7〜-80.8 dB で無音のままです。長さより下処理の有無で結果がそろっています。
E の例外は「こんにちは。」と「京都へようこそ。」の 4 本で、3 本は -16.0〜-33.5 dB、「京都へようこそ。」の seed 2 は -56.5 dB でした。
「金閣寺」seed 2 のスペクトログラムを並べると、違いが目で分かります。各段は、その音声の最大値を基準にした濃さです。
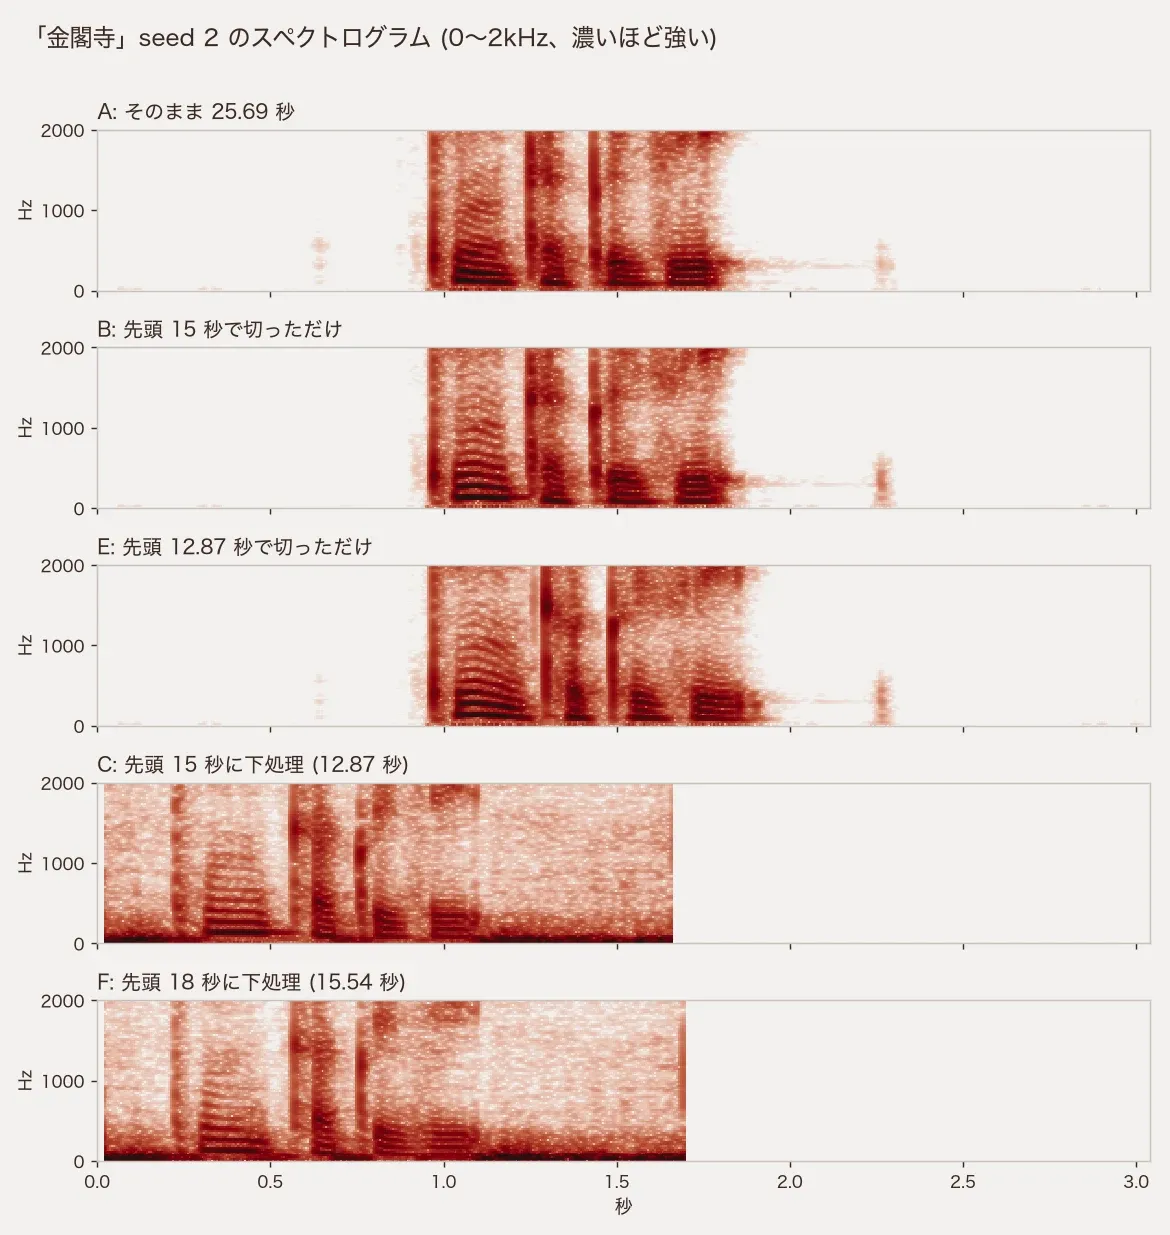
A・B・E は声のない区間がほぼ白く、C・F は低い帯域の濃い帯が声の前から後ろまで続いています。耳で聞いた「BGM のような音」はこの帯です。
出力の長さも分かれました。Irodori は文と参照音声から出力の長さを予測していて (inference_runtime.py)、音が出た R10・C・D・F は同じ文で 1.36〜2.80 秒、出なかった A・B・E は 2.36〜3.80 秒です。単語だけの 5 語では 0.8〜1.4 秒の差があり、音が出る条件では声の前後の余白がほとんどありません。
聴き比べ
図と同じ「金閣寺」seed 2 を、A・B・E (下処理なし)、C・F (下処理あり) の順に載せます。
A (R26 そのまま):
B (先頭 15 秒で切っただけ):
E (先頭 12.87 秒で切っただけ):
C (先頭 15 秒に下処理):
F (先頭 18 秒に下処理):
分かっていないこと
- 下処理のどの段が効いているか。無音を詰める・音量をそろえる・192kHz になる・末尾の無音、の 4 つを一度にかけています。なお Irodori は、渡された参照の音量を内部で -16 dB にそろえています (生成時のメッセージ)
- R10 で音が出る理由。R10 は R26 と別の録音で、下処理はかけていません。0.2 秒ごとに区切った中で最も静かな区間が -45.8 dB と、R26 (-67.8 dB) より 22 dB うるさく、無音らしい区間がほとんどありません。下処理後の C (-53.0 dB) と同じく「間が詰まった参照」という点は共通していますが、それが原因かは確かめていません
- E の 4 本。下処理なしでも、12.87 秒に切ると「こんにちは。」「京都へようこそ。」で音が出ました。C・F ほど強くはなく、スペクトログラムでは 0〜200Hz 付近の弱い帯です
- 出力の長さとの因果。音が出る条件と出力が短い条件は一致していますが、Irodori には出力の長さを秒で指定する設定もあり、長さを固定したときに音が消えるかは試していません
参照音声の扱い
Irodori v4.1-Small に渡す参照は、無音を詰めたり音量をそろえたりせず、録音を切るだけにします。今回の 7 条件では、それで単語の前後の音が消えました。
ほかの TTS 向けに下処理を組んでいる場合、エンジンを替えたらその下処理が新しいエンジンでも良い方向に効くかを確かめたほうがよさそうです。09-13 では Fish Audio に denoise をかけると NG が 3/320 から 21/320 に増え、今回は無音詰めと音量そろえで短い読み上げに音が乗りました。どちらも、前に使っていたエンジン向けに入れた下処理です。
ただし、下処理なしの R10 でも音は出ています。切るだけで音が出なかったのは、静かな間を含む R26 から切った参照でした。手元の録音でも、短い入力を何本か読ませて前後を聴いてから使うのが確実です。
手法と限界
- 生成は RunPod の RTX 4090 で、Irodori-TTS commit 89f9d8f、fp32、ステップ数と CFG はチェックポイント既定、参照の書き起こしは渡していません。前編と同じ設定です
- 条件ごとに 8 文 × seed 2 の 16 本です。seed を増やしたときの割合は測っていません
- 音が出たかどうかは、先頭 0.2 秒の音量が -60 dB を超えたかで判定しました。末尾は文の発声の終わりがかかるので判定に使っていません。耳での確認は一部の音声だけです
- 参照の録音は R10 と R26 の 2 本で、どちらも私の声です。R26 は mp3 から戻した録音です
- 第 1 弾の書き起こしは gpt-4o-transcribe のカタカナ書き起こしで、前編と同じ方法です
生成・参照の作成・計測のコード、130 本ぶんの数値は blog-examples にあります。参照の作り方は make_refs.sh に、09-24 の記事で公開した R26 から同じ参照を作れる形で置いています。