こんにちは、フリーランスエンジニアのmohです。この記事はほとんどAIが書いたものを、私が加筆修正しています。検証不十分な部分もあるかと思いますが、ご容赦ください。ご指摘等ございましたら、Github issueか、Xでお願いいたします。
前々回の記事で、TTS の誤読を全文かな化で潰すと韻律が崩れる問題から「読み指定を持つ TTS への乗り換え」という方針を立て、前回の記事では乗り換え候補の Fish Audio について zero-shot voice clone の一貫性を話者 embedding で測りました。Fish は「毎回、同じ少し違う声が出る」ものの、seed 固定の手段がなく、同一テキストでも尺がぶれるという結果でした。
今回はセルフホスト側の候補、IndexTTS-2.5 を検証します。Bilibili が開発するゼロショット TTS (GitHub / arXiv 2601.03888) で、2.5 で日本語に正式対応し、<漢字|かな> 形式のかな読み指定が入りました。全文かな化に苦しんだ身としては「読み指定がどう実装されていて、どこまで効くのか」が本題です。RunPod の RTX 4090 で、(1) クローン再現性 (2) 試行間一貫性 (3) 読み指定なしの漢字の誤読 (4) 読み指定の機構、の 4 観点 + seed 固定可否を測りました。
結論
- クローン再現性: 同一テキスト 5 回の試行間類似度は 0.9435〜0.9704 (mean 0.9570) で、run 間の話者ブレは小さい。一方 reference と生成物の類似度は 0.83〜0.88 (17 本全体では 0.73〜0.88) で、同一 reference の Fish (0.92 前後) より低い
- 読み指定なしの誤読しやすい漢字 5 文は、今回の試行では転写上明確な誤読が出なかった。「東雲」は「篠野」(「しのの」系)、「代替案」は「代替案」と正転写。ただし
do_sample=Trueの確率生成なので、毎回正しく読まれる保証はない <漢字|かな>読み指定の実装は、トークン化前にかなへ置換する方式だった (verbose ログで実測)。モデルは漢字を見ないので、<東雲|とうめ>のような任意の異読も強制できる (ASR 転写「透明期」)infer()に seed 引数は無く、do_sample=Trueがコードに焼き込まれている。しかし呼び出し前にtorch.manual_seed(42)を固定すると、2 回の生成 wav が MD5 完全一致した。Fish で不可能だった決定性 (尺の固定含む) がセルフホストなら手に入る- RTF はウォームアップ後 0.53〜0.65 (RTX 4090, bf16)。モデルロードは約 107 秒、checkpoint は 5.2GB
- RunPod の罠: runpodctl 2.11.0 の
create podは 2 連続で起動不能だった。GraphQL のpodFindAndDeployOnDemandでsupportPublicIp: trueを明示したら約 40 秒で開通。コストは計約 $1.07 (うち空振り $0.85) - 転写は faster-whisper によるもので、聴取の代替にはならない一次シグナル。ASR 自体の誤りを含み得る
手法
- モデル: IndexTTS-2.5 (IndexTeam/IndexTTS-2.5、checkpoint 5.2GB)。bf16 でロード
- 環境: RunPod Secure Cloud の RTX 4090 24GB ($0.74/hr)。
git clone→uv sync --all-extras→ HF Hub からモデル取得で、SSH 開通からセットアップ完了まで約 3 分 - reference: 前回の Fish 検証と同一の reference (自分の声 約 10 秒、24kHz mono)。シリーズで reference が揃ったので、Fish との対比がしやすくなっています
- 生成 17 本 (全て 22.05kHz mono):
- B: 同一テキストを 5 回 (b_run1〜5) — 試行間一貫性
- B-seed: 同一テキストを
torch.manual_seed(42)固定で 2 回 (b_seed1〜2) — 決定性 - C: 読み指定なしの誤読しやすい漢字 5 文 (c1〜5)
- D:
<漢字|かな>読み指定 5 文 (d1〜5、異読強制 1 文含む)
- 話者類似度: resemblyzer
VoiceEncoderの 256 次元 utterance embedding のコサイン類似度 (前回の Fish 検証と同一指標) - 転写: faster-whisper large-v3 (language=ja, beam5)。聴取の代替にはならない一次シグナルとして使う
検証コードは blog-examples に置いてあります。
検証1: 同一文5回のクローン一貫性
同じ reference・同じテキスト「本日は晴天なり。マイクのテスト中です。この音声は、ゼロショット音声合成のサンプルです。」で 5 回生成し、6x6 (ref + b_run1..5) の類似度行列を取りました。
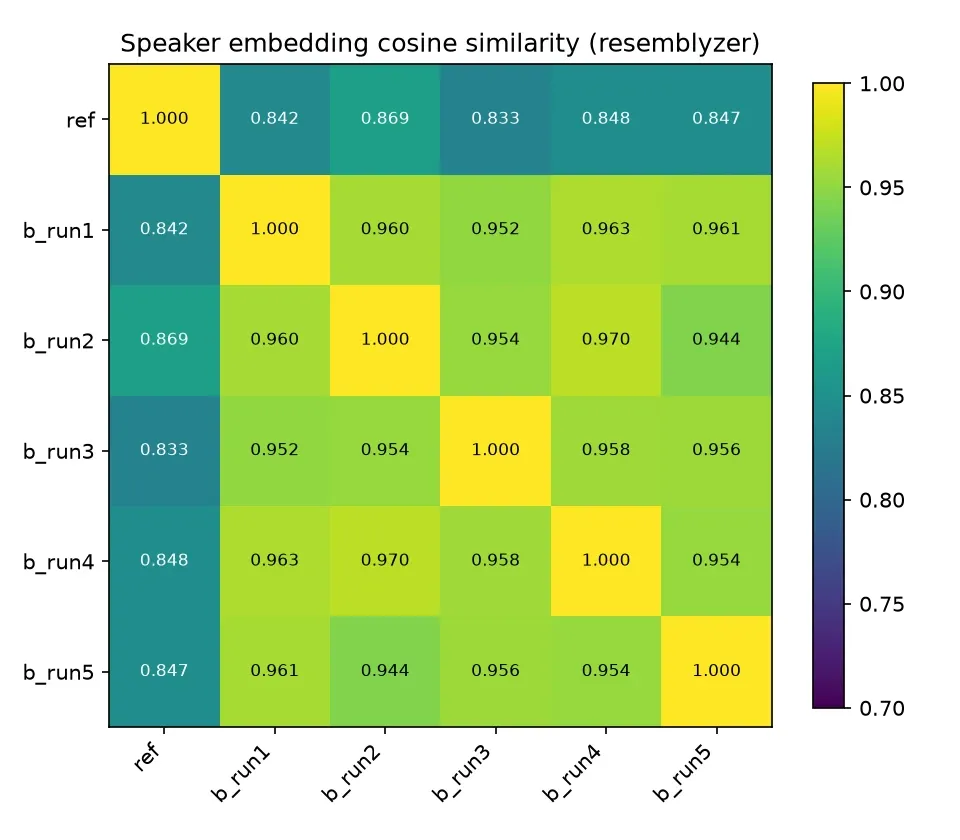
- 試行間 (10 ペア): 0.9435〜0.9704 (mean 0.9570 / std 0.0072)
- ref–run (5 ペア): 0.8331〜0.8692 (mean 0.8477 / std 0.0134)
構図は Fish のときと同じで、生成物同士は近く、ref の行だけ一段低い。「reference から一定距離ずれた声に毎回安定して着地する」パターンです。reference は Fish 検証と同一なので数値も並べやすく、試行間は Fish の 0.9449 ± 0.0156 に対して 0.9570 ± 0.0072 と同水準〜やや高め。一方 ref との類似度は Fish の 0.9163 ± 0.0103 に対して 0.8477 ± 0.0134 と明確に低く、「reference からのずれ」は IndexTTS-2.5 の方が大きく出ました (文章・発話長は異なるので目安です)。
17 本全体では ref 比 0.729〜0.883 で、長文 (b 系、8 秒前後) は 0.83〜0.87、短文 (c5/d4、3〜4 秒) は 0.73〜0.79 まで下がりました。短い発話は embedding 自体が不安定になる要因もあるので、声のずれと指標のぶれの分離はできていません。
b_run1:
b_run3:
同一テキスト 5 回で ASR 転写はほぼ同一でした (「晴天」の当て字違いのみ)。
検証2: 読み指定なしの漢字 — 今回の試行では明確な誤読は出なかった
誤読しやすい漢字を含む 5 文を、読み指定なしで生成しました。faster-whisper large-v3 の転写と並べます。
| tag | 入力テキスト | ASR 転写 |
|---|---|---|
| c1 | 了解しました。明日の朝、東雲駅で待ち合わせましょう。 | 了解しました。明日の朝、篠野駅で待ち合わせましょう。 |
| c2 | 雰囲気のいい店で、代替案について早急に検討した。 | 雰囲気のいい店で代替案について早急に検討した |
| c3 | 彼は人気のない道を歩いた。 | 彼は人気のない道を歩いた |
| c4 | 一日中、日本橋で過ごした。 | 一日中日本橋で過ごした |
| c5 | 今日は八日、明後日は十日です。 | 今日は8日明かっては10日です |
身構えていた「東雲 (しののめ)」は「篠野」と転写されました。後述の d1 (しののめ指定) の転写「篠ノ宮」と同じ「しのの」系の音で、誤読とは言えません。「代替案」も正転写。「人気」「日本橋」「八日・十日」も転写上は妥当です (c5 は「8日」「10日」と数値化されており読み分け成立と整合。「明後日」が「明かって」と転写された点だけは怪しく、要聴取)。繰り返しますが ASR は聴取の代替にならないので、注目の 2 本を置いておきます。
c1 (東雲):
c2 (代替案):
今回の試行では 全文かな化の記事で見たような明確な誤読は出ませんでした。ただし後述のとおり生成は do_sample=True の確率的サンプリングで、毎回正しく読まれる保証はありません。「出た時に確実に直せる」手段として、読み指定を見ていきます。
検証3: <漢字|かな> 読み指定はトークン化前のかな置換
本題です。読み指定を付けて 5 文生成しました。
| tag | 入力テキスト | ASR 転写 |
|---|---|---|
| d1 | 明日の朝、<東雲|しののめ>駅で待ち合わせましょう。 | 明日の朝、篠ノ宮駅で待ち合わせましょう |
| d2 | 彼は料理が<上手|じょうず>だが、囲碁では<上手|うわて>に負けた。 | 彼は料理が上手だが囲碁では上手に負けた |
| d3 | <人気|ひとけ>のない道を歩いた。 | 人気のない道を歩いた |
| d4 | <人気|にんき>のない道を歩いた。 | 人気のない道を歩いた |
| d5 | 明日の朝、<東雲|とうめ>駅で待ち合わせましょう。 | 明日の朝透明期で待ち合わせましょう |
d1 は「篠ノ宮」と転写され、「しのの…」の音が出ています。d2 の同表記異読 (じょうず / うわて) も出現箇所ごとに指定でき、前処理ログでは 2 箇所がそれぞれ指定かなに置換されていました (転写は同表記の漢字に戻るため、転写だけでは読み分けを確定できません)。
d1 (しののめ指定):
d2 (じょうず / うわて):
実装がどうなっているかは verbose=True のログで分かります。d1 の前処理後トークン列はこうでした。
明日 の 朝 , しののめ 駅 で 待ち合わせ ましょう .つまり <東雲|しののめ> は、トークン化前に「指定かなへの置換」として処理されています。モデルは漢字「東雲」を一切見ません。これを確かめるために入れたのが d5 で、存在しない読み <東雲|とうめ> を指定したところ、ログは「とうめ 駅」となり、ASR も「透明期」と拾いました。指定したかながそのまま読まれる、つまり任意の読みを強制できる機構です。
d5 (とうめ強制):
これは全文かな化と読み指定の中間の性質です。指定した語だけがかなになり、文の残りは漢字かな交じりのままなので、韻律の手掛かりを丸ごと消す全文かな化よりは局所的。一方 Fish のインライン phoneme タグと違って、記法として指定できるのはかな表記のみで、アクセントまでは指定できません。「ひとけ」と「にんき」の指定違いも聴き比べてみてください。
d3 (ひとけ):
d4 (にんき):
検証4: seed 引数は無いが、外部固定で決定的になる
前回の Fish 検証で残った課題が非決定性でした。同一テキストでも尺が std 0.33 秒でぶれ、seed を固定する API もない。IndexTTS-2.5 はどうか。
inspect で実測した infer() のシグネチャに seed パラメータはありません。
IndexTTS2.infer(self, spk_audio_prompt, text, output_path, lang,
    emo_audio_prompt=None, emo_alpha=1.0, emo_vector=None, use_emo_text=False,
    emo_text=None, use_random=False, interval_silence=200, verbose=False,
    max_text_tokens_per_segment=120, stream_return=False, more_segment_before=0,
    duration_factor=1.0, text_normalization=True, **generation_kwargs)
use_random は感情行列のランダム選択用でサンプリング seed ではなく、**generation_kwargs の既定は do_sample=True, top_p=0.8, top_k=30, temperature=0.8, num_beams=3, repetition_penalty=10.0。しかも do_sample は引数として pop された後、内部でリテラルの do_sample=True が渡されるため、False を指定しても greedy にはできません (infer_v2_5.py で確認)。
それでもセルフホストなら外から RNG を固定できます。infer() 呼び出し前に torch.manual_seed(42) 等を固定して 2 回生成したところ、出力 wav は MD5 完全一致 (37ef735909968421b035518f29250ae9) でした。尺も 7.66 秒で完全に同一です。seed なしの 5 回では尺が 7.58〜8.22 秒でぶれていたので、「同じ入力なら同じ音声」をバイト単位で保証できるのは大きい。リップシンクなど尺に制約のある動画用途で、Fish の非決定性に対する明確なアドバンテージです。
速度: RTF 0.53〜0.65 (RTX 4090, bf16)
モデルロードは 107.2 秒 (bf16、BigVGAN CUDA kernel のビルド含む)。生成はウォームアップ後 RTF 0.53〜0.65 で、初回のみ 0.911 でした。短文ほど固定オーバーヘッドの比率が上がり RTF が悪化します。
| 条件 | 音声秒 | RTF |
|---|---|---|
| 長文 8 秒前後 (b_run2〜5) | 7.66〜8.22 | 0.534〜0.546 |
| 中文 5 秒前後 (c1, c2) | 5.27〜5.47 | 0.543〜0.564 |
| 短文 3〜5 秒 (c3〜5, d1〜5) | 2.67〜4.83 | 0.570〜0.653 |
max_mel_tokens 超過の RuntimeWarning は 0 件で、全 17 生成が 1 セグメントで完結しました。
RunPod の罠: runpodctl の create pod が起動しない
検証より先にここで時間を溶かしました。runpodctl 2.11.0 の create pod で立てた Pod は、2 連続で 30〜38 分待っても runtime.uptime=0・ports=null のまま起動しませんでした。GraphQL の podFindAndDeployOnDemand mutation で supportPublicIp: true を明示して立て直したところ、約 40 秒で SSH 開通。runpodctl はこのフラグを送っていない模様です。
| Pod | 稼働 | 概算 |
|---|---|---|
| 1 台目 (起動失敗) | 約 31 分 | $0.38 |
| 2 台目 (起動失敗) | 約 38 分 | $0.47 |
| 3 台目 (本番) | 約 18 分 | $0.22 |
| 合計 | 約 87 分 | 約 $1.07 |
検証本体は 18 分 $0.22 で終わっており、$0.85 は起動失敗の空振りです。起動しない Pod も課金対象時間が発生し得るので、uptime が付かない Pod は粘らず即消して立て直す方が安い。なお本記事の測定値は reference を差し替えて再実行したもので、その再実行は最初から GraphQL で立てて 1 Pod 約 11 分・$0.14 で完了しています (作成から SSH 開通まで約 2 分)。
Fish Audio との対比
このシリーズの文脈 (誤読対策 → zero-shot clone の一貫性) で、2 つを並べます。reference は同一 (自分の声 約 10 秒) ですが、文章・発話長が異なるため、数値の直接比較は目安です。
| 項目 | Fish Audio s2.1-pro (前回) | IndexTTS-2.5 (今回) |
|---|---|---|
| 試行間一貫性 (同一文 5 回) | 0.9449 ± 0.0156 | 0.9570 ± 0.0072 |
| ref 比類似度 (同一文 5 回) | 0.9163 ± 0.0103 | 0.8477 ± 0.0134 |
| seed 固定 | 不可 (API に無し、尺 std 0.33 秒) | API 引数は無いが torch.manual_seed で MD5 一致 |
| 読み指定 | インライン phoneme タグ (アクセント指定可) | <漢字|かな> かな置換 (かな表記のみ) |
| 実行形態 | クラウド API | セルフホスト (今回 RunPod 4090, $0.74/hr) |
試行間の安定度は同水準〜IndexTTS-2.5 がやや上、reference への忠実度は Fish が明確に上、という結果になりました。読み指定の表現力は Fish (アクセントまで指定可)、決定性はセルフホストの IndexTTS-2.5、という分かれ方です。
指標の限界
- resemblyzer 単一指標の客観測定で、聴感上の同一性・韻律の自然さは別途評価が必要です
- 短い発話 (3〜4 秒) の embedding は不安定になりやすく、短文の類似度低下 (0.73〜0.79) を声のずれとは断定できません
- ASR 転写は聴取の代替にならない一次シグナルです。「篠野」「篠ノ宮」「透明期」等は読み・強制読みと整合する転写ですが、ASR 自体の誤りを含み得ます
- 「明確な誤読は出なかった」は今回の 1 試行での結果です。生成は確率的サンプリングなので、誤読しないことの保証にはなりません
- Fish との数値比較は reference は同一ですが、文章・発話長が異なる条件間の比較です
まとめ
IndexTTS-2.5 の日本語 zero-shot clone は、試行間 0.944〜0.970 で定量上の一貫性は高い一方、ref 比は 0.83〜0.88 (b 系) で、同一 reference の Fish (0.92 前後) より reference からのずれが大きく出ました。読み指定なしの誤読しやすい漢字は、今回の試行では転写上明確な誤読が出ませんでしたが、確率生成なので保証はありません。<漢字|かな> 読み指定はトークン化前のかな置換で、モデルは漢字を見ないため任意の読みを強制できます。誤読修正の道具としては十分ですが、アクセント記法はありません。
一番の収穫は決定性です。API に seed は無く do_sample=True が焼き込まれているにもかかわらず、外部から torch.manual_seed を固定すれば wav が MD5 一致する。Fish では原理的に手に入らなかった「同じ入力なら同じ尺・同じ音声」が、セルフホストなら手に入ります。RTF 0.53〜0.65 (4090, bf16)・検証一式 1 Pod 約 11 分 $0.14 という実行コストも含めて、尺に制約のある動画用途では有力な選択肢になりそうです。