こんにちは、フリーランスエンジニアのmohです。この記事はほとんどAIが書いたものを、私が加筆修正しています。検証不十分な部分もあるかと思いますが、ご容赦ください。ご指摘等ございましたら、Github issueか、Xでお願いいたします。
ElevenLabs の声のクローンには 2 種類あります。Professional Voice Cloning (PVC) は 30 分以上の録音から作る高品質版ですが、公式の FAQ に「同意があっても他人の声はクローンできない」とあり、作れるのは本人の声だけです。もう一方の Instant Voice Cloning (IVC) は短い録音から即時に作る方式で、作成時に「その声をクローンする権利と同意がある」ことの確認を求められます。他人の声を扱うなら、実質的に IVC が選択肢になります。
では IVC の声はどれだけ本人に似るのか。ElevenLabs については多言語の比較記事で読み上げ内容の正確さ (CER) を見ただけで、声の類似度は測っていませんでした。そこで自分の声 10 秒から IVC を作り、eleven_v4 で同一文・異文・7 言語の 17 本を生成して、resemblyzer の話者 embedding のコサイン類似度で測りました。参照音声と生成テキストは以前の記事で使ったものを借りています。
結論
- 試行間・文章間でよく揃う。同一文 5 回の試行間類似度は 0.9825 ± 0.0035 で、10 ペアの最小でも 0.9781。文章を変えた 5 本の間でも 0.9639 ± 0.0071
- 参照音声 (本人) との類似度は、同一文で 0.8495 ± 0.0112、異文で 0.8384 ± 0.0204。生成物同士よりはっきり低い
- 同じ文をクローンではない別人の声 (ElevenLabs のライブラリ音声、日本語男性) で読ませると、参照音声との類似度は 0.5317 だった。IVC の 0.84〜0.85 はこれよりはるかに本人側にある
- 声が高くなる。F0 mean は参照音声 104.38 Hz に対し、同一文 5 本で 124.86〜131.92 Hz。半音にして 3.5 つ分ほど高い
- 日本語の参照音声から 7 言語で生成すると、言語間の類似度は 0.8778 ± 0.0232、参照音声との類似度は 0.8132 ± 0.0310。言語判定は 7/7 で指定どおり
- 聴いた印象でも、声の同一性はわりと保たれていた。違うのは気持ち (抑揚) の付け方だけ。同一文 5 本の F0 mean が 124.86〜131.92 Hz の幅で動いていることと合う
- 参照音声は 10 秒で、IVC の公式推奨 (1〜2 分) より短い。推奨どおりの長さなら参照音声との類似度は上がる可能性がある。また数値の測定は resemblyzer の 1 指標だけで、聴感は筆者 1 人が聴いた印象
手法
- 参照音声: 自分の声 約 10 秒 (24kHz mono)。08-26 の記事と同じファイル
- IVC: API (
POST /v1/voices/add) で参照音声 1 本から 1 つ作成。remove_background_noise=false。IVC の API には書き起こしの項目が無いので、書き起こしは渡していない。測定後に削除 - モデル: 公式の models ページが最新のフラッグシップとして挙げる
eleven_v4 - 生成:
output_format=wav_24000。voice_settingsは送らず既定値 (stability 0.5、similarity_boost 0.75、speaker boost on)。seedも指定しない - テキスト: 同一文 ×5、異文 ×5、7 言語 ×1 の計 17 本 (08-26 の記事の実験1・実験2・実験5 と同じ文)。全件成功
- 話者類似度: resemblyzer
VoiceEncoderの 256 次元 utterance embedding 同士のコサイン類似度。F0 は librosapyin。言語判定は faster-whisper (small) - 基準: ElevenLabs のライブラリ音声 Shohei (日本語男性、クローンではない) で同一文を 1 本生成し、参照音声との類似度を取った
測定コードと生成音声は blog-examples に置いてあります。
全体
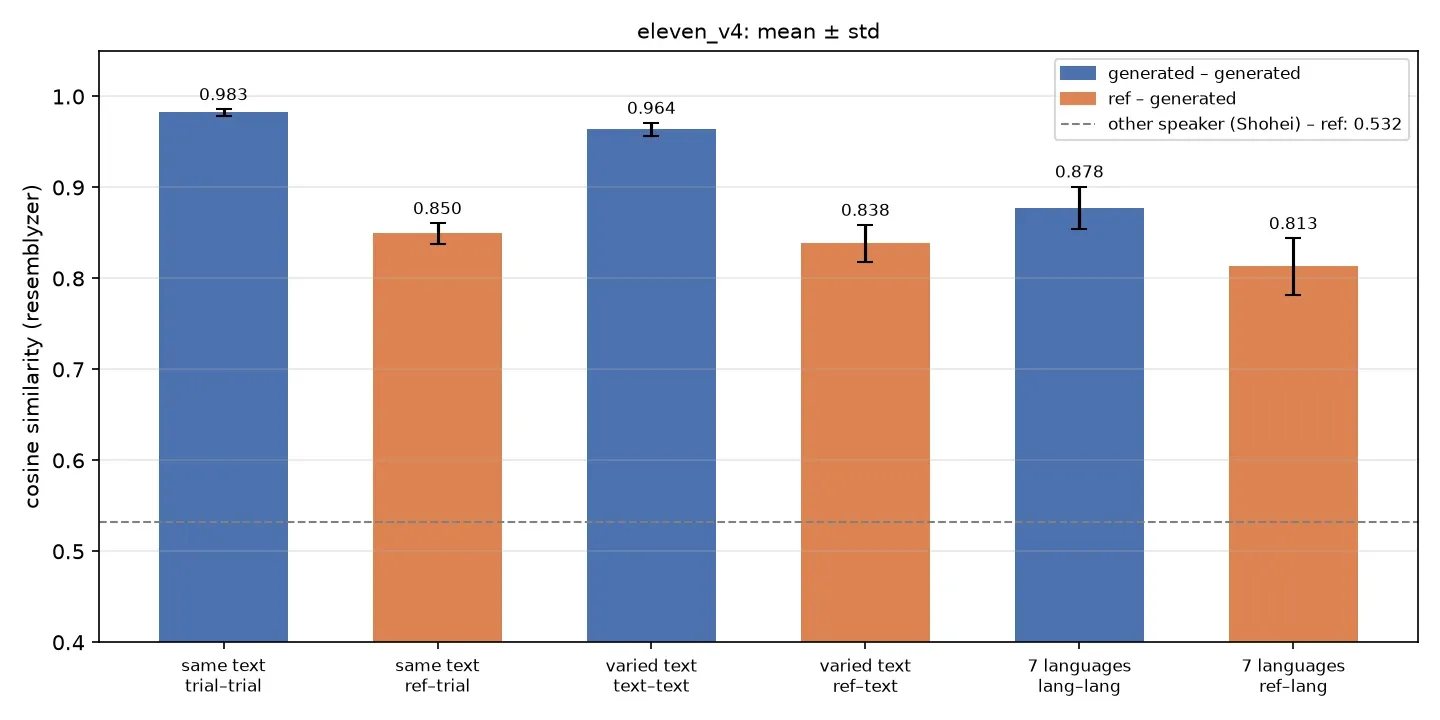
| 群 | mean ± std |
|---|---|
| 同一文: 試行間 (10 ペア) | 0.9825 ± 0.0035 |
| 同一文: 参照音声–試行 (5) | 0.8495 ± 0.0112 |
| 異文: 文章間 (10 ペア) | 0.9639 ± 0.0071 |
| 異文: 参照音声–文章 (5) | 0.8384 ± 0.0204 |
| 同一文 × 異文 (25 ペア) | 0.9573 ± 0.0102 |
| 7 言語: 言語間 (21 ペア) | 0.8778 ± 0.0232 |
| 7 言語: 参照音声–言語 (7) | 0.8132 ± 0.0310 |
| 7 言語: ja–他言語 (6 ペア) | 0.8901 ± 0.0254 |
| 別人の声 (ライブラリ音声 Shohei) – 参照音声 (1) | 0.5317 |
別人の基準は 1 人分しかないので、「0.53 前後なら別人」という線として一般化はできません。ただ、IVC の参照音声との類似度 (0.81〜0.85) は、どの条件でもこの基準より本人に大きく寄っています。
実験1: 同一文を5回生成する
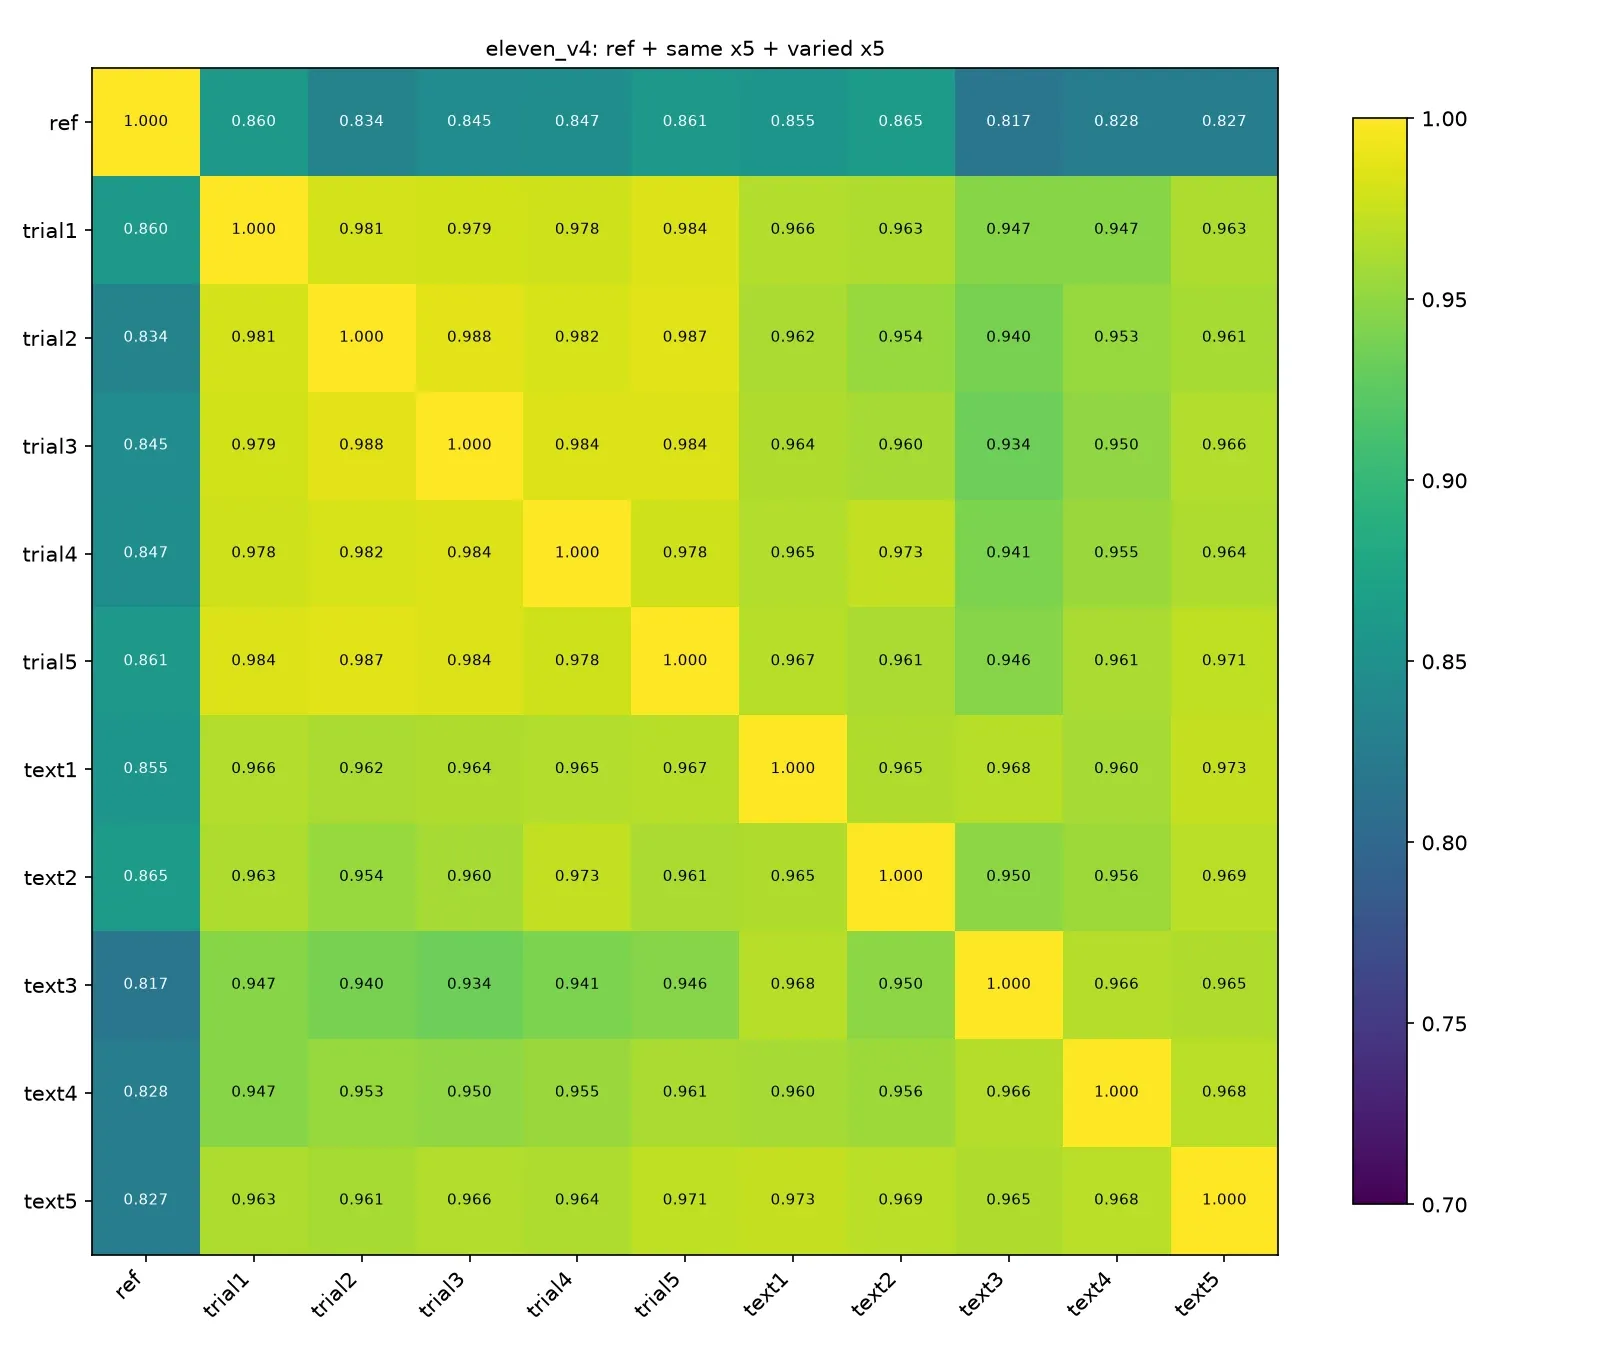
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| 試行間 | 同一文同士 | 10 | 0.9825 | 0.0035 | 0.9781 | 0.9880 |
| 参照音声–試行 | 5 | 0.8495 | 0.0112 | 0.8341 | 0.8613 |
5 回の試行はほぼ同じ声で、10 ペアの最小でも 0.9781 です。seed を指定していないので生成のたびに乱数は変わっているはずですが、声のぶれはこの指標ではほとんど見えません。尺も 12.72〜13.04 秒 (std 0.13 秒) と揃っていました。
実際に 5 本を聴き比べても、声の同一性はわりと保たれていて、違うのは気持ち (抑揚) の付け方だけでした。数値で見ても、尺は揃っている一方で F0 mean は 124.86〜131.92 Hz の幅で動いており、抑揚の違いが音の高さに出ています。
一方、参照音声との類似度は 0.83〜0.86 で、試行同士より 0.13 ほど低い位置にあります。毎回同じ声が出て、その声は本人から少し離れたところにあります。参照音声はどの生成物とも文章が違うので、この差には音素内容の違いも混ざります (指標の限界を参照)。
trial1 です。参照音声そのものは公開していません。
実験2: 文章を変えて5本生成する
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| 文章間 | 異文同士 | 10 | 0.9639 | 0.0071 | 0.9495 | 0.9731 |
| 参照音声–文章 | 5 | 0.8384 | 0.0204 | 0.8173 | 0.8650 | |
| 同一文 × 異文 | 25 | 0.9573 | 0.0102 | 0.9339 | 0.9726 |
文章を変えても、5 本の間は 0.96 台で揃っています。同一文の試行間 (0.9825) より少し下がりますが、異文のペアには音素内容の違いが混ざるので、この差を声の変化とは読めません。参照音声との類似度は実験1 とほぼ同じ水準 (0.8384) で、文章によって本人から遠ざかる様子はありません。
text1 です。
F0: 声が高くなる
| F0 mean | |
|---|---|
| 参照音声 | 104.38 Hz |
| 同一文 5 本 | 124.86〜131.92 Hz |
| 異文 5 本 | 126.17〜134.40 Hz |
| 7 言語 | 126.59〜140.89 Hz |
生成物はすべて、参照音声より 20〜37 Hz 高い帯に出ました。同一文 5 本の平均 128.28 Hz は、参照音声から半音 3.5 つ分ほど上です。pyin の推定誤りでないかを別の推定法 (librosa の yin、音量の大きい半分のフレームの中央値) でも確かめましたが、参照音声 104.64 Hz に対し trial1 130.81 Hz と同じ向きの差が出ています。言語を変えても高い側に寄ったままです。
参照音声との類似度が生成物同士より低い理由の候補として、この声の高さの違いが考えられます。ただ、resemblyzer の embedding が声の高さにどれだけ反応するかは今回の測定では分けられないので、因果までは言えません。
実験3: 言語を変える
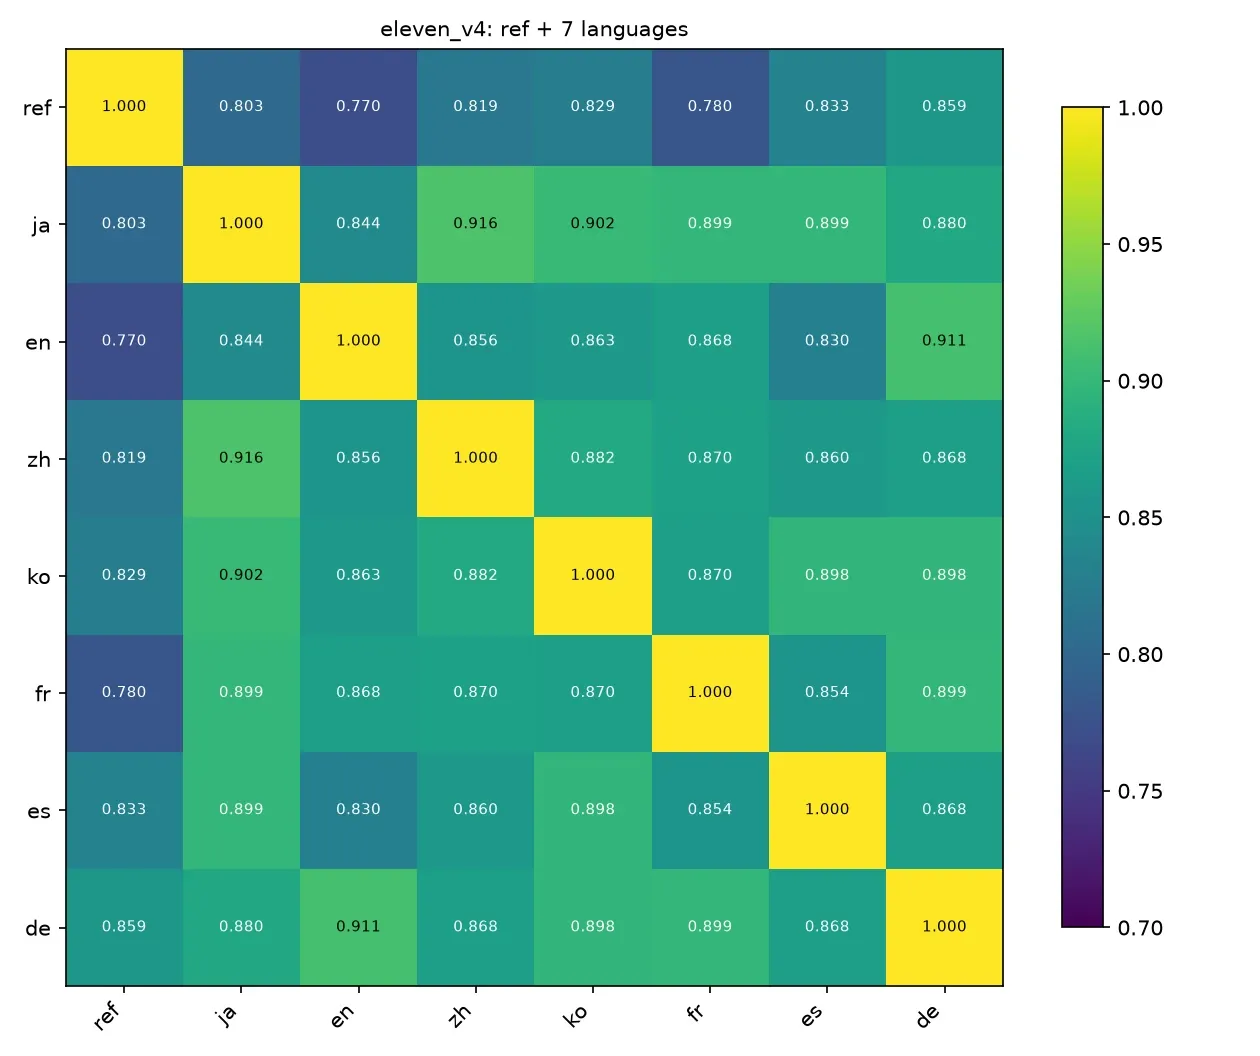
| 群 | 条件 | n | mean | std | min | max |
|---|---|---|---|---|---|---|
| 参照音声–言語 | 7 言語 | 7 | 0.8132 | 0.0310 | 0.7703 | 0.8587 |
| 言語間 | 異言語同士 | 21 | 0.8778 | 0.0232 | 0.8303 | 0.9164 |
| ja–他言語 | 6 | 0.8901 | 0.0254 | 0.8439 | 0.9164 |
言語判定は faster-whisper (small) で 7/7 が指定どおりの言語で、書き起こしも生成テキストとほぼ一致しました。
言語間の類似度は 0.88 前後で、日本語内の異文 (0.9639) より下がります。この低下には声の変化のほかに、音素体系の差と resemblyzer の言語バイアスが混ざります。参照音声との類似度は日本語の実験よりさらに下がり、最も低いのは en (0.7703) と fr (0.7802)、最も高いのは de (0.8587) でした。ja も 0.8030 で、同じ日本語の実験1・2 (0.84〜0.85) より低く出ています。7 言語の文は実験1・2 より短い (4.88〜6.56 秒) ので、短い音声で embedding が安定しにくいことも影響しているかもしれません。
en です。
指標の限界
- 参照音声は 10 秒で、IVC の公式推奨 (1〜2 分) より短い。推奨どおりの長さで作った IVC は測っていない
voice_settingsは既定値 (similarity_boost 0.75 など) だけを測った。similarity_boost を上げたときの変化は見ていない- 指標は resemblyzer の utterance embedding の 1 つだけ。話者性を主に捉えるが、音素内容 (何を喋っているか) の影響を完全には除けない。参照音声はどの生成物とも文章が違うので、参照音声との類似度は常に音素内容の差を含む
- resemblyzer の VoiceEncoder は英語中心のデータ (VoxCeleb 系) で学習されており、多言語の類似度には encoder の言語バイアスが混ざる
- 別人の基準は ElevenLabs のライブラリ音声 1 人分だけ。話者を増やした分布は取っていない
- 各条件 5〜7 本、1 日の測定。聴感は筆者 1 人が聴いた印象で、複数人での評価はしていない
まとめ
ElevenLabs の Instant Voice Clone を eleven_v4 で読ませると、試行や文章を変えても声がよく揃いました。同一文の試行間は 0.98、異文の間でも 0.96 です。聴いても声の同一性はわりと保たれていて、違うのは気持ち (抑揚) の付け方だけでした。参照音声 (本人) との類似度は 0.84〜0.85 で、別人の声 (0.53) よりはるかに本人寄りですが、生成物同士ほどは近くありません。声の高さも参照音声より半音 3.5 つ分ほど高く出ました。
他人の声を IVC で作る用途では、「毎回同じ声が出るか」の心配は小さく、「本人にどこまで寄せられるか」が論点になります。公式推奨の 1〜2 分の参照音声や、similarity_boost を上げた設定で本人への近さが変わるかは、まだ測っていません。